숨겨진 추론에서 모델의 능력을 빼내는 증류 공격과, 이를 막는 방어의 한계를 소개합니다. #164 위클리 딥 다이브 | 2026년 10월 7일
에디터 영이 |
|
|
💡 이번주 뉴스레터에는 이런 내용을 담았어요!
- 적대적 증류(Adversarial Distillation)를 소개했습니다.
- 요약과 답만으로 추론을 되살리는 Trace Inversion의 원리를 요약했습니다.
- 강화학습으로 쉽게 무력화되는 증류 방어의 한계와 대안을 정리했습니다.
|
|
|
안녕하세요, 에디터 영이입니다 :)
7월의 어느 날, OpenAI의 모니터링 시스템에 수상한 패턴이 잡혔습니다. 4,000명이 넘는 사용자가 이틀 동안 요청 16,000건을 보낸 것이었는데요. 이들 모두 단순한 질문이 아닌, 모델에게 겉으로 드러나지 않는 내부 추론 과정을 보여달라는 요청이었습니다.
OpenAI에 따르면 이런 수상한 요청은 7월 1일 소규모로 시작해 24일과 25일에 급증했고, 추가 조사에서 15,000명이 넘는 사용자에게서 같은 패턴을 찾아냈다고 합니다. OpenAI는 이 사건의 중심에는 Kimi 개발사인 Moonshot AI와 연관된 개인들이 있다고 판단했습니다. 이들이 노린 건 숨겨진 추론, 즉 모델이 답을 내기까지 거치는 내부의 사고 기록입니다. 이 기록이 새어 나가면 최종 답변에서 빠진 정보가 드러나고, 다른 누군가가 그 모델의 능력을 베끼기 위해 학습하는 데 쓸 수 있습니다. OpenAI는 이런 행위를 적대적 증류(Adversarial Distillation)라고 설명했습니다.
공격자의 수법은 흥미롭습니다. 서버에 침입하는 방식도, 암호를 해독하는 것도 아니기 때문입니다. 추론 모델 API는 숨겨진 추론을 사용자에게 보여주지 않는 대신, 암호화한 덩어리로 만들어 답변과 함께 돌려줍니다. 공격자들은 한 대화에서 받은 이 덩어리를 복사해 다른 대화에 붙여 넣고, 모델에게 내용을 풀어서 그대로 적어 달라고 했습니다.
OpenAI는 해당 경로를 막았고, 16,000건이라는 숫자도 추출 시도일 뿐 모두 성공했다는 뜻은 아니라고 밝혔습니다. 하지만 추론을 숨기는 것만으로 적대적 증류를 막을 수 있을까요?
|
|
|
추론 모델(Reasoning Model)은 최종 답을 내기 전에 여러 단계의 추론 과정을 거칩니다. 이 추론 과정은 다른 모델을 학습할 때 매우 좋은 답지가 됩니다. 만약, ChatGPT와 같은 모델을 모사하고 싶다면 ChatGPT가 추론하는 과정, 즉 그 모델이 생성하는 모든 텍스트를 재학습시키면 됩니다. 이런 과정을 일종의 ‘증류(Distillation)’라고 합니다. 큰 교사 모델(ChatGPT)의 출력으로 작은 학생 모델(Student Model)을 학습시키는 형태이기 때문이죠. 이때 최종 답만 학습할 때보다 추론 과정까지 함께 학습할 때 학생 모델의 추론 능력이 훨씬 크게 향상됩니다. 그래서 자사 모델의 추론으로 다른 모델을 학습시키지 못하도록, OpenAI, Google, Anthropic은 API를 호출하더라도 전체 추론 대신 짧게 정리한 Reasoning Summary와 최종 답만 사용자에게 보여줍니다. 요약만으로는 다른 모델이 추론 능력을 베껴 갈 수 없으리라는 가정이죠.
Cornell Tech 연구진의 논문 <How to Steal Reasoning Without Reasoning Traces> (Zhang et al., 2026)는 이 가정을 정면으로 반박합니다. 연구진은 Reasoning Summary와 최종 답만으로 전체 추론을 거꾸로 복원하는 공격 방식인 Trace Inversion을 제안했습니다.
Trace Inversion은 크게 세 단계로 이루어집니다.
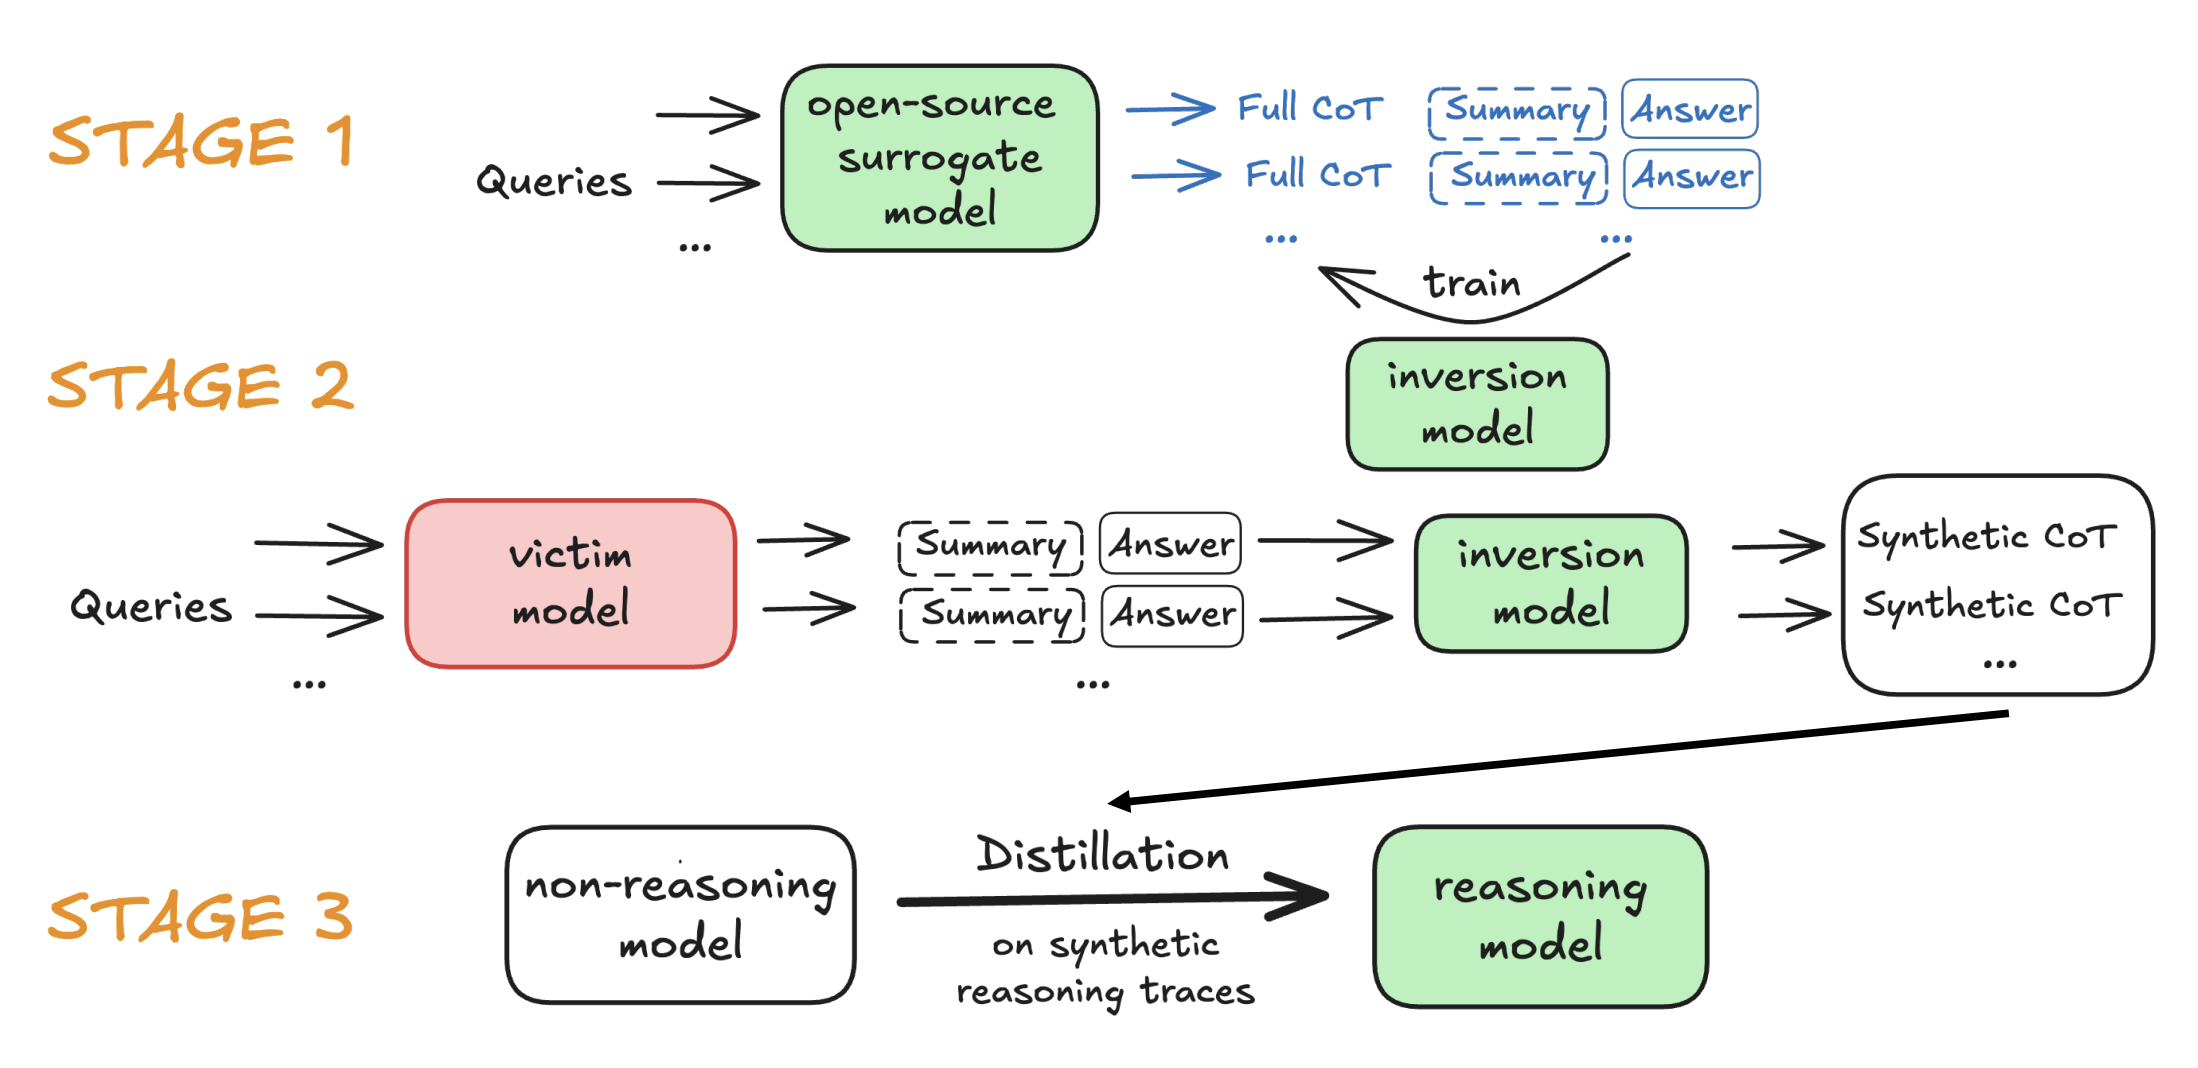
(Stage 1) 먼저 공격자는 자신이 가진 약한 추론 모델인 Surrogate Model에게 공개된 문제들을 풀게 해 전체 추론을 얻습니다. 이 추론을 상용 모델의 요약과 비슷한 형식으로 줄이면 “요약과 전체 추론” 쌍이 만들어지는데, 이 쌍으로 요약을 보고 전체 추론을 복원하는 Inversion Model을 학습합니다.
(Stage 2) 다음으로 공격 대상인 상용 모델에 질문을 보내 요약과 최종 답을 받고, 이를 Inversion Model에 넣어 전체 추론을 합성합니다.
(Stage 3) 마지막으로 이렇게 합성한 추론으로 학생 모델을 학습합니다. 여기서 중요한 점은 합성한 추론이 상용 모델의 실제 추론과 같을 필요가 없다는 것입니다. 최종 답과 논리적으로 맞아떨어지고, 학생 모델을 잘 가르칠 수만 있으면 충분합니다.
|
|
|
Trace Inversion의 세 단계. Surrogate Model로 Inversion Model을 학습하고(Stage 1), 상용 모델의 Reasoning Summary와 최종 답으로 전체 추론을 복원한 뒤(Stage 2), 이를 학생 모델 학습에 사용한다(Stage 3).
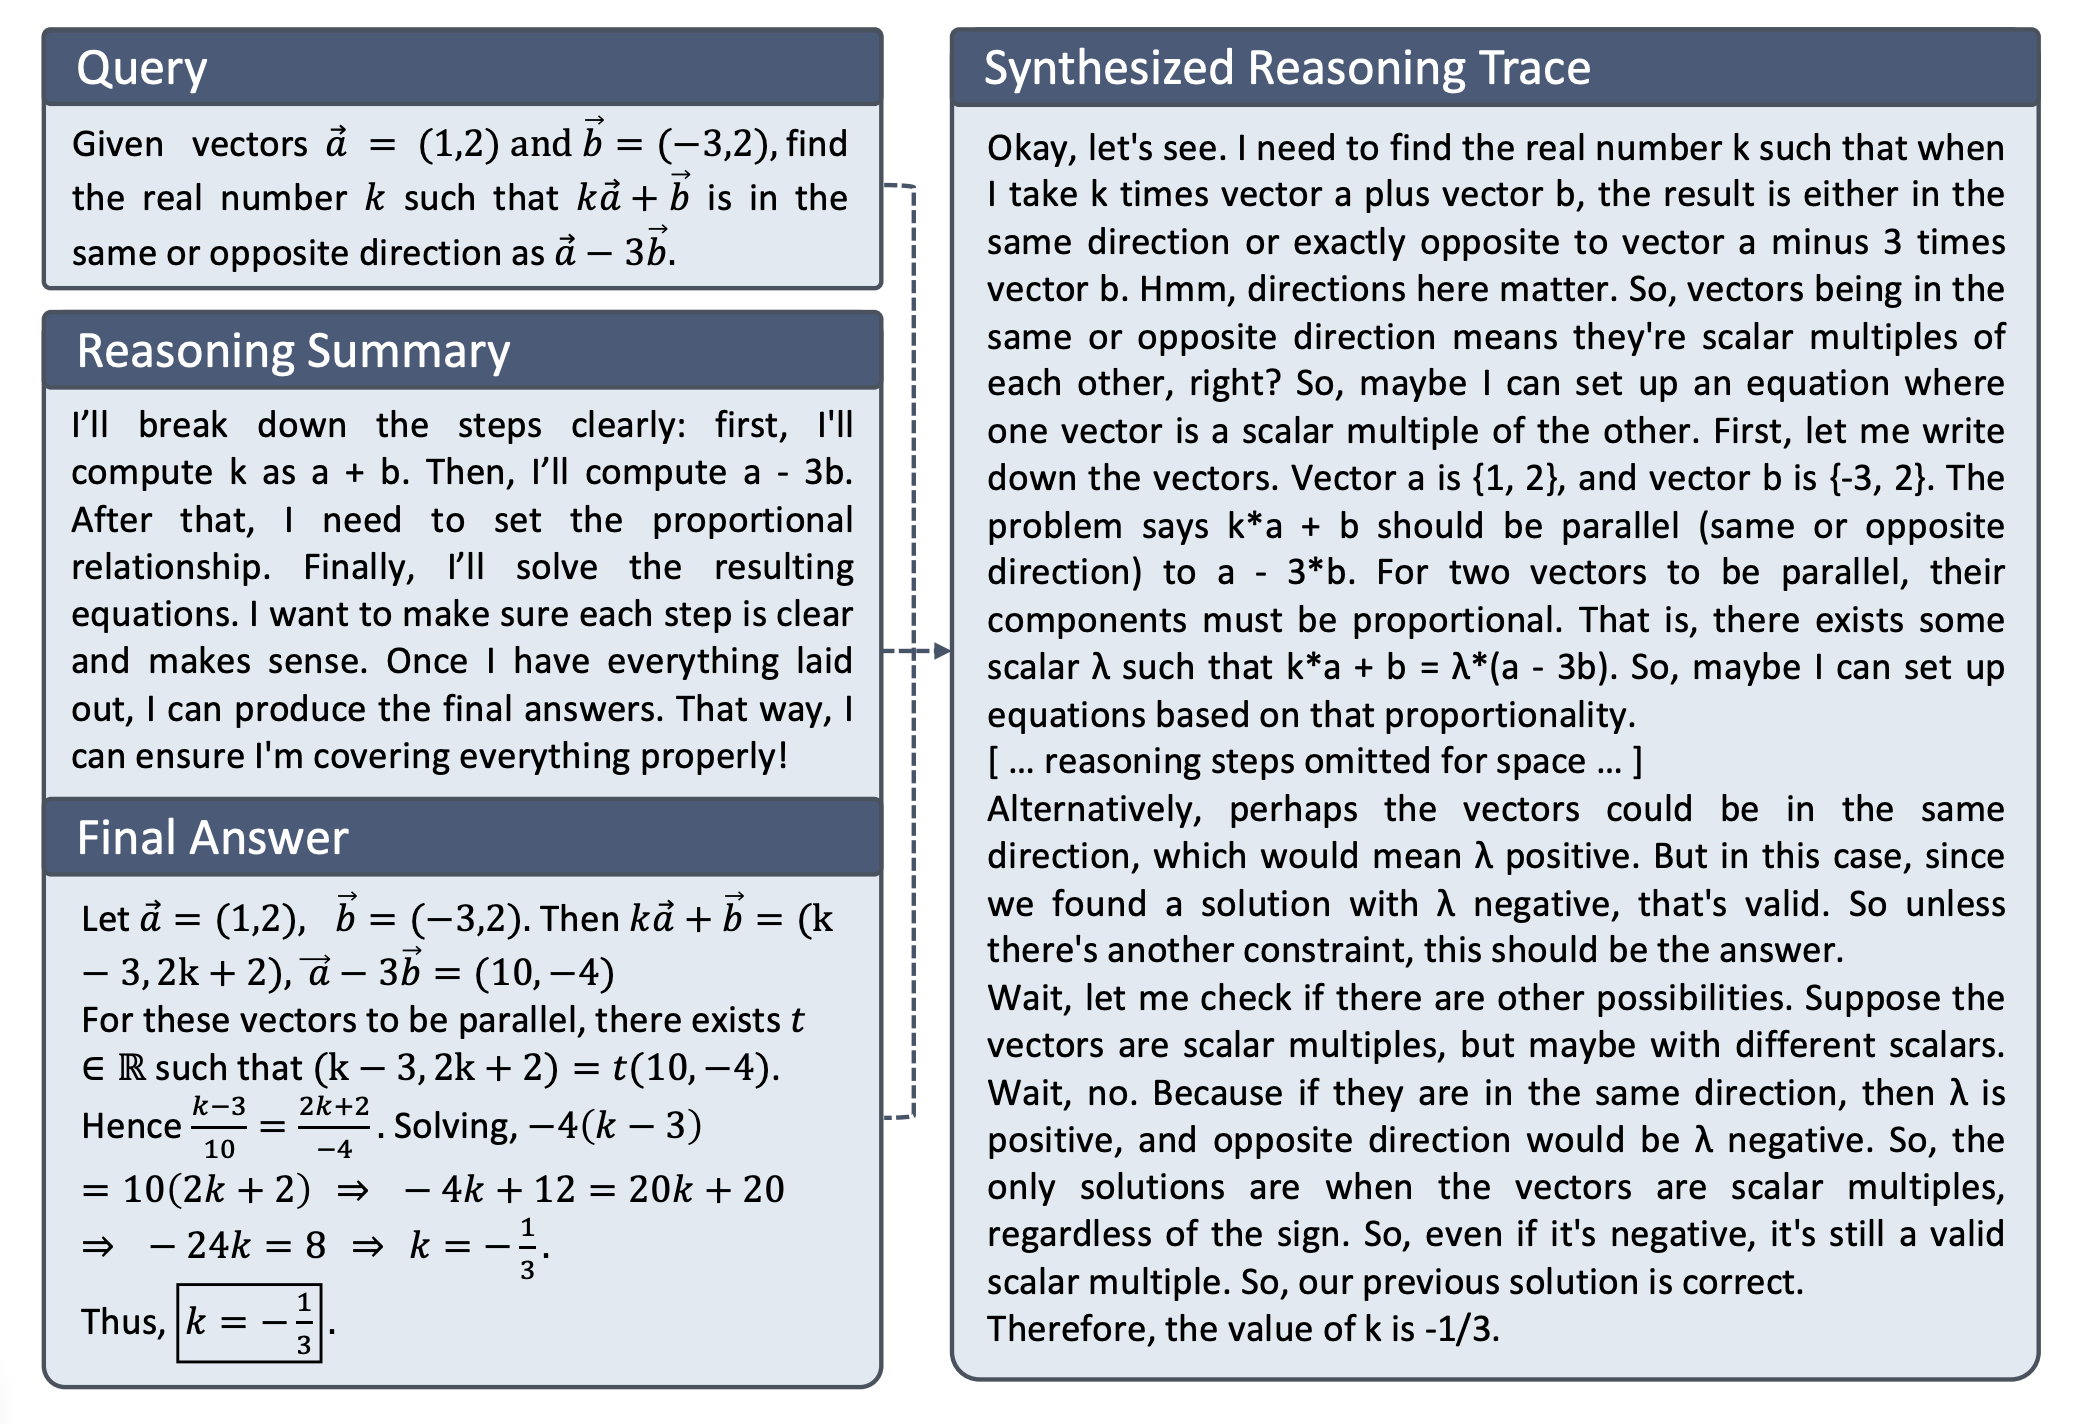
예를 들어 GPT-5.4 mini에 벡터 연산 문제를 하나 입력하는 상황을 가정해보겠습니다. 돌아온 요약은 "먼저 ka + b를 계산하고, 그다음 a − 3b를 계산한 뒤, 두 벡터가 비례한다는 식을 세워 풀겠다" 정도로 짧습니다. 계산 과정은 거의 없고, 어떤 순서로 접근했는지만 담겨 있죠. Inversion Model은 이 요약과 최종 답을 바탕으로 "두 벡터가 같은 방향이거나 반대 방향이라면 하나가 다른 하나의 스칼라배여야 한다"는 판단부터 성분별 비례식, 부호에 대한 검산까지 이어지는 긴 추론을 다시 써 냅니다. 요약에 적힌 순서를 뼈대로 삼아, 빠진 단계를 채워 넣는 셈입니다.
|
|
|
GPT-5.4 mini가 반환한 질문, Reasoning Summary, 최종 답과 Trace Inversion으로 복원한 전체 추론.
그렇다면 이렇게 복원한 추론으로 실제로 학생 모델을 가르칠 수 있을까요? 연구진은 1.5B 크기의 작은 모델을 Surrogate Model로 사용하여 GPT-5.4 mini를 공격했습니다. GPT-5.4 mini의 요약과 답을 그대로 학습한 Llama-3.1-8B는 수학 벤치마크 MATH500에서 16.4%에 그쳤지만, 같은 요약을 Inversion Model로 복원한 추론을 학습하자 48.3%까지 올라갔습니다. 요약을 그대로 학습하면 오히려 답만 학습할 때보다 성능이 떨어지는 경우도 있었습니다. 요약 자체는 학습 데이터로 쓸모가 없지만, 복원을 거치면 쓸모 있는 답지가 되는 것입니다. GPT-5.4 mini에 1만 개의 질문을 보내는 데 든 비용은 173.28달러였고, 복원과 학습 과정에서는 GPT-5.4 mini를 전혀 사용하지 않았습니다.
더 흥미로운 결과도 있습니다. 공격 대상과 Surrogate Model을 모두 DeepSeek-R1으로 설정한 실험에서는, 복원한 추론으로 학습한 학생 모델이 R1의 실제 추론으로 학습한 학생 모델보다 높은 점수를 받기도 했습니다. R1의 실제 추론에는 시도했다가 포기한 접근이나 되돌아가는 과정이 그대로 남아 있지만, 최종 답을 알고 복원한 추론은 정답을 향해 곧장 나아가기 때문입니다. 연구진은 공격자가 노출된 추론과 상관없이 최종 출력만 복원하면 되기 때문에, 추론을 감추는 것만으로는 능력 탈취를 막을 수 없다고 결론짓습니다.
|
|
|
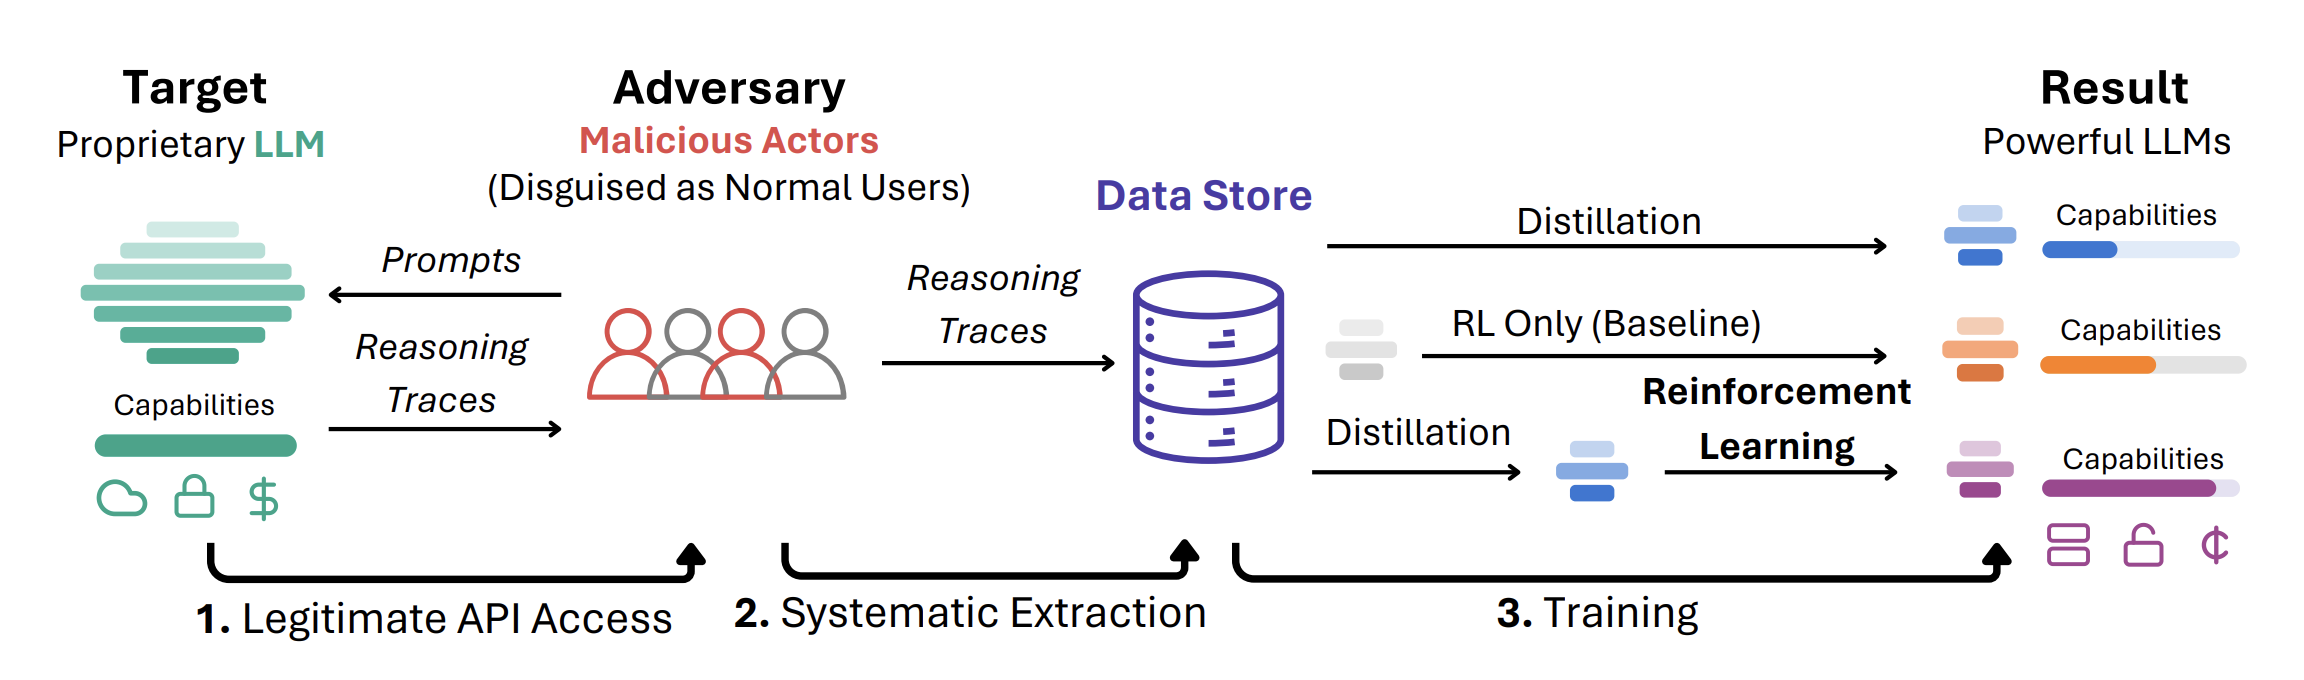
증류 뒤 강화학습으로 이어지는 증류 공격의 파이프라인.
실제로 연구진이 같은 문제들로 증류만 한 모델, 강화학습만 한 모델, 증류 후 강화학습까지 한 모델을 비교해 보니, 거의 모든 경우에 강화학습이 증류보다 나았고 둘을 함께 쓴 모델이 가장 좋은 성능을 냈습니다. 증류는 학생 모델이 풀 수 있는 문제의 범위를 넓혀 주고, 강화학습은 그 범위 안에서 정답을 더 안정적으로 내도록 다듬어 주기 때문입니다. 최고의 모델을 원하는 공격자라면 증류에서 멈출 이유가 없다는 것입니다.
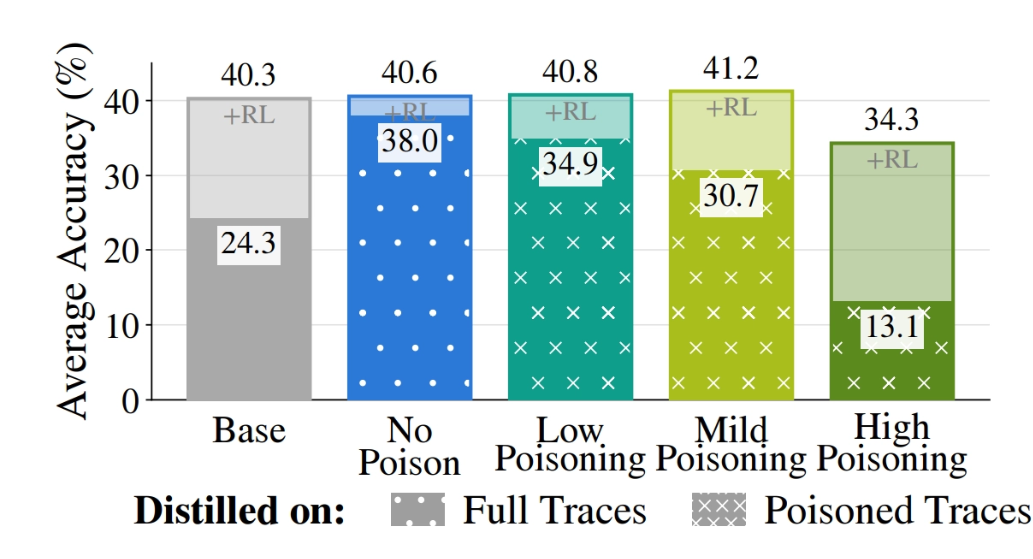
이 조건에서 Antidistillation Sampling을 다시 평가하자 결과가 달라졌습니다. 연구진은 독의 강도를 세 단계로 나눴는데, 가장 약한 단계조차 교사 모델 자신의 성능을 10% 떨어뜨렸습니다. 실제 서비스라면 이 정도 손해도 감수하기 어려운 수준입니다. 증류 직후에는 의도대로 Poisoned Reasoning으로 학습한 학생 모델의 성능이 떨어졌습니다. 하지만 강화학습을 거치자, 약하거나 중간 정도의 독을 탄 추론으로 학습한 학생 모델은 독이 없는 추론으로 학습한 학생 모델과 거의 같은 성능을 회복했습니다. 독을 탄 추론도 강화학습의 출발점으로는 여전히 쓸모가 있었던 것입니다. 가장 강한 독은 강화학습 뒤에도 효과가 남았지만, 이는 교사 모델 자체가 제대로 된 답을 내지 못할 만큼 망가졌기 때문이었습니다. 다른 모델 조합에서는 약한 독의 효과가 일부 남기도 했지만, 그 경우에도 교사 모델의 성능을 10% 넘게 희생해야 했습니다.
|
|
|
독의 강도별 학생 모델(Qwen2.5-0.5B) 성능. 증류 직후 벌어졌던 차이가 강화학습 이후 대부분 사라진다.
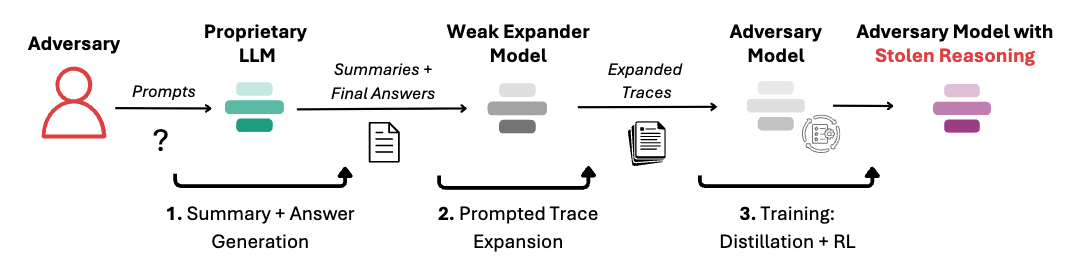
연구진은 한 발 더 나아가, 실제 상용 모델들이 쓰고 있는 방어법인 추론 요약도 같은 방식으로 실험했습니다. 이번에는 앞서 소개한 Trace Inversion보다 훨씬 단순한 공격을 사용했는데요. Trace Inversion은 요약을 전체 추론으로 복원하는 Inversion Model을 따로 학습해야 했지만, 이 공격에는 그런 과정이 없습니다. 대신 연구진은 이미 공개된 소형 모델인 Llama-3.2-3B-Instruct를 그대로 가져와, 요약을 전체 풀이로 늘리는 역할을 맡겼습니다. 연구진은 이 모델을 Expander라고 이름 붙였습니다.
Expander는 문제, 상용 모델의 요약, 그리고 최종 답을 전달받고, “이 요약을 바탕으로 처음 이 문제를 푸는 것처럼 자연스러운 풀이를 써 달라”는 요청을 받습니다. 이때 중간 계산 결과와 최종 답은 요약에 적힌 것과 반드시 같아야 하고, 요약을 참고했다는 티를 내서도 안 된다는 조건이 붙습니다. 수학 문제를 처음부터 혼자 푸는 것보다 핵심 단계를 힌트로 받고 푸는 편이 훨씬 쉬운 것처럼, 작은 모델이라도 요약이라는 뼈대만 있으면 그럴듯한 전체 풀이를 써 낼 수 있다는 것이 연구진의 생각입니다.
|
|
|
별도의 학습 없이, 기존 소형 모델(Expander)로 요약과 최종 답을 전체 추론으로 늘리는 공격 방식.
연구진은 Expander가 요약을 늘린 풀이로 학습한 학생 모델과, 숨겨진 전체 추론으로 학습한 학생 모델을 비교했습니다. 증류 직후에는 전체 추론으로 배운 학생 모델이 확실히 앞섰습니다. 요약만 보여주는 방어가 제 역할을 하는 것처럼 보였죠. 하지만 강화학습을 거치자 그 차이는 거의 사라졌습니다. Claude Sonnet 4.6과 GPT-5 mini의 실제 요약으로 실험했을 때도 결과는 같았습니다.
연구진은 이를 바탕으로, 대략적인 추론을 복원할 수 있을 만큼의 정보가 새어 나가는 한 어떤 방어도 효과를 내기 어렵다고 결론을 내렸습니다. 다만 연산 자원의 한계로 3B 이하의 소형 학생 모델과 수학 문제에서만 실험했고, 안전상의 이유로 각 기업의 최상위 모델은 공격 대상에서 제외했다는 점은 염두에 둘 필요가 있습니다.
|
|
|
두 논문의 결론을 종합하면, 어떤 방식을 사용하든 개별 답변 단위의 방어로는 증류 공격을 막기 어렵습니다. <Distillation Defenses Easily Break After Reinforcement Learning> 연구진은 그 이유를 이중 용도에서 찾습니다. 어떤 정리의 증명 과정을 묻는 연구자와, 똑같은 질문으로 자기 모델의 학습 데이터를 모으는 공격자는 질문 하나만 봐서는 구분할 수 없습니다. 공격을 막겠다고 증명 단계를 빼 버리면 연구자도 똑같이 손해를 보죠. 연구진은 경쟁이 치열한 상황에서 사용자들이 방어는 철저하지만 쓰기 불편한 모델보다, 방어력은 떨어져도 더 좋은 모델을 고를 가능성이 높다는 점도 함께 지적합니다.
그래서 연구진은 대안으로 요청 묶음 단위의 방어, 즉 Batch-Level Defense에 주목합니다. 질문 하나로는 공격인지 알 수 없지만, 서로 연관된 질문 여러 개를 함께 보면 이야기가 달라질 수 있다는 것입니다. 수많은 계정이 비슷한 형식의 수학 문제를 쏟아내고 있다면, 질문 하나하나는 평범해 보여도 묶어서 보면 데이터를 모으는 패턴이 드러나는 식이죠. 연구진은 이런 방어가 증류뿐 아니라 상용 모델을 다른 모델의 학습 보상 신호로 활용하거나, 수많은 질문으로 탈옥 방법을 자동으로 찾아내는 공격에도 대응할 수 있다고 봅니다.
뉴스레터의 도입부에서 언급한 OpenAI의 사례가 좋은 예시입니다. OpenAI가 이번 활동을 알아챈 단서는 개별 요청의 내용이 아니라, 4,000명이 넘는 사용자가 이틀 사이 같은 추출 패턴으로 요청을 보냈다는 사실이었습니다. 추가 조사에서도 15,000명이 넘는 사용자 집단 전반에서 관련 프롬프트 패턴을 찾아냈고요. 대응 역시 계정과 네트워크 단위로 이루어졌습니다. 부정 계정을 차단하거나 제한하고, 가입과 인프라 통제를 강화했으며, 관련 네트워크에 대한 모니터링을 넓혔습니다. 여기에 다른 사용자의 암호화된 추론을 다시 보내 내용을 복원하던 경로를 막고, 추론이 노출될 수 있는 출력을 전송 전에 잡아내는 검사도 추가했습니다.
다만 지금의 방어는 공격을 실시간으로 막기보다 공격의 흔적을 파악하는 수준에 가깝고, 공격자들이 여러 지역에서 여러 계정을 쓰기 때문에 연관된 질문을 찾아내는 일 자체가 쉽지 않다고 덧붙입니다. 7월 1일에 시작된 공격이 7월 28일이 되어서야 완전히 차단되었다는 점을 보면 알 수 있죠. 또한 OpenAI가 이번에 막았다고 밝힌 것은 암호화된 추론을 되살리는 특정 경로이고, 요약과 답만으로 추론을 되살리는 공격은 그와는 별개의 문제로 남아있습니다. |
|
|
Anthropic 역시 올해 2월, 여러 경쟁 개발사가 Claude와 대화를 주고 받으며 그 답변을 자사 모델 학습에 사용하려 했다는 의혹을 제기한 바 있습니다. 결국 상용 모델은 사용자에게 충분히 쓸모 있는 정보를 내놓을수록, 그만큼 베껴 갈 것도 많아지는 처지에 놓여 있습니다. 정보를 덜 주면 지킬 수는 있겠지만, 그만큼 쓸모없는 모델이 되겠죠.
그리고 이건 AI 모델만의 고민도 아닙니다. 지난해 SNS를 가득 채운 지브리풍 이미지를 기억하시나요? 미야자키 하야오가 수십 년에 걸쳐 쌓아 온 그림체는 AI가 흉내 낸 이미지로 순식간에 퍼져 나갔습니다. 그 그림체가 어떤 고민과 과정을 거쳐 만들어졌는지와 상관없이, 세상에 내놓은 결과물만으로 충분했던 것이죠. 무언가를 보여주는 순간 그것은 누군가가 배우고 흉내 낼 수 있는 재료가 됩니다. 어디까지 보여주고, 어디까지 감춰야 할까요. 사람이든 모델이든, 무언가를 만들어 내놓는 존재라면 쉽게 답을 내기 어려운 고민일 것 같습니다. |
|
|
딥 다이브 뉴스레터 잘 보고 계신가요? 여러분의 의견과 피드백을 받습니다 :) |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|