Agent 프로그램 전체를 바라보는 새로운 LLM Serving 방식을 살펴봅니다. #163 위클리 딥 다이브 | 2026년 9월 30일
에디터 잭잭 |
|
|
💡 이번주 뉴스레터에는 이런 내용을 담았어요!
- 하나의 Agent 작업이 여러 번의 LLM 호출로 이루어지고, 이 호출들이 실제로 어떤 구조에서 처리되는지 살펴봅니다.
- 여러 Agent 프로그램이 동시에 실행될 때 생길 수 있는 프로그램 단위 Scheduling 문제와, 여러 Engine 사이에서 KV Cache를 어떻게 재사용할지 알아봅니다.
- 개별 LLM 호출이 아니라 Agent 프로그램 전체의 실행 이력과 Context를 함께 고려하는 Agentix의 핵심 아이디어를 소개합니다.
|
|
|
Agent Serving: 한 접시가 아니라 코스 요리 |
|
|
안녕하세요, 에디터 잭잭입니다.
우리가 LLM 챗봇 서비스, 예를 들어 ChatGPT를 사용할 때는 보통 질문을 입력하고 잠시 뒤 답변을 받습니다. 사용자에게는 한 번의 요청과 한 번의 응답처럼 보이지만, 서비스 뒤에서는 동시에 들어오는 수많은 요청을 어떤 GPU에서 처리할지, 어떤 요청을 먼저 실행할지, 생성 과정에서 필요한 메모리를 어떻게 관리할지 계속 결정해야 하죠.
이처럼 동시에 들어오는 여러 LLM 요청을 어떤 GPU에서, 어떤 순서로 처리할지 관리하는 것을 LLM Serving이라고 합니다. 모델 자체의 성능이 아무리 뛰어나더라도 요청이 몰렸을 때 응답이 오래 걸리거나 GPU 자원을 비효율적으로 사용한다면, 실제 서비스에서는 좋은 사용자 경험을 제공하기 어렵습니다.
최근에는 우리가 AI를 사용하는 방식이 조금씩 달라지고 있습니다. 질문에 답을 받는 데서 그치지 않고, “이 자료로 PPT를 만들어줘”, “이 코드를 고치고 실행해줘”처럼 하나의 작업 자체를 AI에게 맡기는 경우가 늘고 있죠. 이런 작업을 수행하는 AI Agent는 한 번의 LLM 호출(Call)로 끝나는 것이 아니라, 목표를 달성하기 위해 여러 번 LLM을 호출하고 도구(Tool)를 사용하며 중간 결과에 따라 다음 행동을 결정합니다.
기존 LLM Serving이 각각의 LLM 요청을 효율적으로 처리하는 데 집중했다면, Agent에서는 서로 연결된 여러 LLM 호출로 이루어진 작업 전체를 얼마나 빠르게 끝낼 수 있는지까지 고려해야 합니다.
그렇다면 기존의 LLM Serving 시스템을 Agent에도 그대로 적용하는 것만으로 충분할까요?
|
|
|
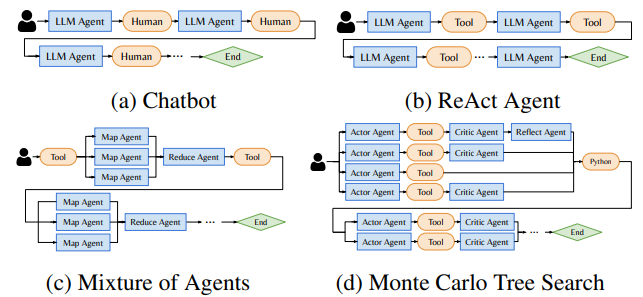
Agent의 작업은 한 번의 LLM 호출로 끝나지 않는다는 점에서, 개별 LLM 호출 작업과 차이가 있습니다. 하나의 목표를 해결하는 동안 여러 번 LLM을 호출하고, 도구를 사용하거나 사람의 입력을 받으면서 다음 단계로 이어지죠. 뿐만 아니라 이런 호출들이 이어지는 방식도 Agent의 종류에 따라 달라집니다. 어떤 프로그램은 하나의 흐름을 따라 순차적으로 진행되고, 어떤 프로그램은 여러 갈래로 나뉘어 동시에 진행되기도 합니다.
|
|
|
그림의 (a) Chatbot을 보면 LLM Agent와 사람의 입력이 번갈아 이어집니다. (b) ReAct Agent 역시 LLM이 판단한 뒤 도구(Tool)를 사용하고, 그 결과를 다시 바탕으로 다음 LLM 호출을 이어가는 구조입니다. 이런 경우처럼 하나의 실행 흐름을 따라 호출이 순차적으로 이어지는 형태를 단일 스레드 프로그램(Single-threaded Program)이라고 합니다.
반면 (c) Mixture of Agents나 (d) Monte Carlo Tree Search(MCTS)처럼 하나의 작업 안에서 여러 실행 흐름이 갈라지는 경우도 있어요. 여러 Agent의 LLM 호출이 병렬로 진행되거나 여러 Branch를 탐색한 뒤, 그 결과를 모아 다음 단계로 넘어갈 수 있죠. 이런 구조를 다중 스레드 프로그램(Multi-threaded Program)이라고 합니다.
여기서 구분해야 할 것은 LLM 호출과 Agent 프로그램의 단위가 다르다는 점이에요. 그림의 파란색 박스 하나가 모델에 입력을 보내고 결과를 받는 한 번의 LLM 호출이라면, 에이전트 프로그램(Agentic Program)은 이런 여러 LLM 호출과 Tool 사용, 사람의 입력 등이 연결되어 하나의 목표를 수행하는 전체 실행 흐름을 뜻합니다.
|
|
|
AI Agent는 어떤 인프라 위에서 동작할까? |
|
|
앞에서는 Agent 프로그램의 특성을 살펴봤습니다. 그렇다면 Agent 프로그램에서 만들어진 여러 LLM 호출은 실제 서비스 안에서 어디로 전달되고, 어떤 방식으로 처리될까요? 이를 이해하려면 Agent가 동작하는 전체 구조를 한 번 살펴볼 필요가 있습니다. |
|
|
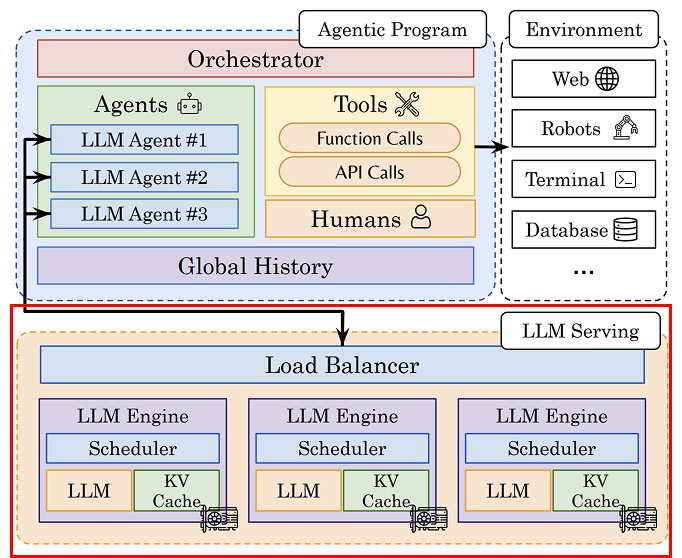
Agent의 실행 구조. 위쪽의 Agentic Program이 Agent, Tool, 사람의 입력을 연결해 작업을 진행하면, 그 과정에서 발생한 LLM 호출은 아래쪽 LLM Serving으로 전달됩니다. Agent는 필요에 따라 웹, 터미널, 데이터베이스 같은 외부 환경(Environment)과도 상호작용합니다.
AI Agent의 실행 구조는 크게 Agentic Program 계층과 LLM Serving 계층으로 나눌 수 있어요. 먼저 그림의 상단부인 Agentic 프로그램에서는 하나 이상의 Agent가 하나의 목표를 수행합니다. Agent는 필요에 따라 함수나 API 같은 도구(Tool)를 사용하고, 사람의 입력을 받을 수도 있죠. Orchestrator는 Agent와 Tool이 언제 실행될지 전체 흐름을 조정하고, Global History에는 Agent와 Tool, 사람이 주고받은 정보가 누적됩니다.
이번 글에서 특히 주목할 부분은 빨간 박스로 표시된 LLM Serving 계층인데요. Agentic Program에서 LLM이 필요할 때마다 LLM 호출이 이 계층으로 전달됩니다. 여기서 LLM Engine은 실제 모델 추론을 수행하고 KV Cache 등을 관리하는 실행 단위입니다. 여러 Engine이 있다면 Load Balancer가 호출을 어느 Engine으로 보낼지 정하고, 각 Engine의 Scheduler는 들어온 호출 가운데 무엇을 먼저 실행할지 결정합니다.
즉 사용자에게는 하나의 Agent 작업으로 보이지만, 실제로는 Agentic Program이 여러 LLM 호출과 Tool 사용을 만들어내고, 그중 LLM 호출들은 다시 LLM Serving 시스템에서 스케줄링되고 여러 Engine에 배치되어 처리되는 구조입니다.
|
|
|
기존 LLM Serving은 Agent를 처리할 때 무엇을 놓칠까? |
|
|
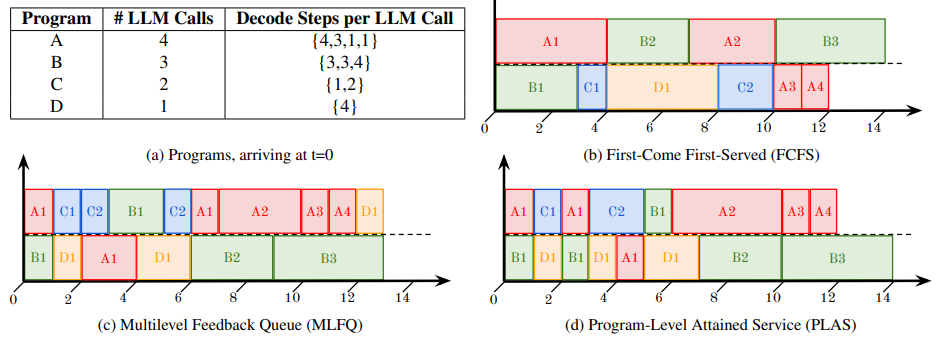
앞에서는 하나의 에이전트 프로그램을 살펴봤습니다. 이번에는 실제 서비스처럼, 서로 다른 목표를 가진 여러 에이전트 프로그램이 동시에 실행되는 상황을 생각해보겠습니다. 그림에서는 Program A, B, C, D가 각각 하나의 작업이고, A1 → A2 → A3 → A4처럼 하나의 프로그램 안에서 여러 LLM 호출이 이어집니다.
이때 서로 다른 프로그램에서 나온 LLM 호출들은 같은 GPU 자원을 두고 경쟁하게 됩니다. 기존 LLM Serving 시스템은 주로 개별 LLM 호출을 얼마나 효율적으로 처리할지에 초점을 맞춰왔지만, Agent 환경에서는 이것만으로 충분하지 않을 수 있습니다. |
|
|
긴 Program A·B와 짧은 Program C·D를 서로 다른 방식으로 스케줄링한 예시. 가로축은 시간을 나타내고, 위아래의 두 행은 동시에 실행할 수 있는 두 개의 실행 슬롯을 나타냅니다.
본격적으로 그림을 보기 전에 구조부터 간단히 짚어보겠습니다. 가로축은 시간을 나타내고, 위아래의 두 행은 동시에 실행할 수 있는 두 개의 실행 슬롯을 나타냅니다. 각 색깔 박스는 하나의 LLM 호출이고, 박스가 길수록 해당 호출이 GPU를 더 오래 사용한다는 뜻이에요. A1, A2, A3처럼 같은 알파벳으로 표시된 박스들은 하나의 프로그램에서 이어서 발생한 LLM 호출입니다.
이 그림은 Head-of-Line(HoL) Blocking 문제를 보여줍니다. HoL Blocking이란, 앞의 긴 작업(A, B) 때문에 뒤의 짧은 작업(C, D)이 실행되지 못하고 기다리게 되는 현상인데요. Agent 환경에서는 이 문제가 프로그램 단위로도 나타날 수 있습니다. 긴 프로그램이 후속 LLM 호출을 계속 만들어내면서 다른 짧은 프로그램 전체를 반복해서 뒤로 밀 수 있기 때문입니다.
그림의 스케줄링 방식을 하나씩 보면, (b) FCFS(First-Come First-Served)는 들어온 순서대로 LLM 호출을 처리합니다. 그래서 긴 프로그램 A와 B의 호출이 실행되는 동안, 짧은 Program C와 D는 뒤에서 기다리게 됩니다. (c) MLFQ(Multi-Level Feedback Queue)는 오래 실행되는 호출을 중간에 멈추고, 다른 호출에 실행 기회를 줄 수 있습니다. 다만 새로 들어온 호출은 다시 높은 우선순위에서 시작한다는 한계가 있습니다. 예를 들어 A1 이후 A2가 들어오면, 호출 하나만 놓고 봤을 때는 새로운 호출이지만, 프로그램 전체로 보면 이미 A1을 실행한 Program A의 후속 호출인거죠.
|
|
|
💡 스케줄링 알고리즘
- FCFS (First-Come First-Served): 먼저 도착한 LLM 호출부터 순서대로 실행하는 단순한 선착순 스케줄링 방식입니다. 구현은 간단하지만, 앞에 긴 호출이 있으면 뒤의 짧은 호출도 함께 오래 기다릴 수 있습니다.
- MLFQ (Multi-Level Feedback Queue): 여러 개의 우선순위 큐를 두고, 오래 실행된 호출의 우선순위를 낮추는 스케줄링 방식입니다. 긴 호출이 GPU를 계속 점유하지 못하게 하고, 새로 들어온 호출이나 아직 적게 실행된 호출에 더 빠르게 실행 기회를 줍니다.
|
|
|
이 차이를 고려하지 않으면 A와 B가 후속 호출을 만들 때마다 다시 앞쪽으로 들어오면서, 짧은 Program D가 계속 뒤로 밀릴 수 있습니다. 그림의 MLFQ에서도 D1이 여러 번 실행을 양보하며 뒤로 밀리는 모습을 볼 수 있죠.
사용자 입장에서는 비교적 간단한 Agent 작업을 맡겼는데도, 다른 긴 Agent 작업의 후속 호출이 계속 먼저 처리되면서 내 작업 전체가 예상보다 늦게 끝나는 상황이 생길 수 있습니다.
이를 해결하기 위해 Agentix가 제안하는 핵심은 LLM 호출 하나가 아니라, 그 호출이 속한 프로그램 전체를 기준으로 스케줄링하는 것입니다. A2가 새로 들어온 호출이더라도, Program A가 앞에서 이미 얼마나 실행됐는지까지 함께 보는 것이죠.
뒤에서 자세히 살펴볼 PLAS(Program-Level Attained Service)가 이런 방식입니다. 그림의 (d) PLAS에서는 이미 실행 기회를 많이 받은 A와 B의 후속 호출을 뒤로 미루고, 상대적으로 덜 실행된 C와 D를 먼저 처리함으로써, 짧은 프로그램이 긴 프로그램의 후속 호출에 계속 밀리는 현상을 줄일 수 있어요. |
|
|
Scheduler: 어떤 프로그램을 먼저 실행할까? |
|
|
이제 Agentix가 실제로 어떤 구조로 동작하는지 살펴보겠습니다.
Agentix는 프로그램 단위의 정보를 바탕으로 크게 두 가지 결정을 내립니다. Scheduler는 여러 LLM 호출 중 무엇을 먼저 실행할지, Load Balancer는 선택된 호출을 어느 LLM Engine에서 실행할지 정하죠. 여기서는 먼저 Scheduler를 다루려고 해요.
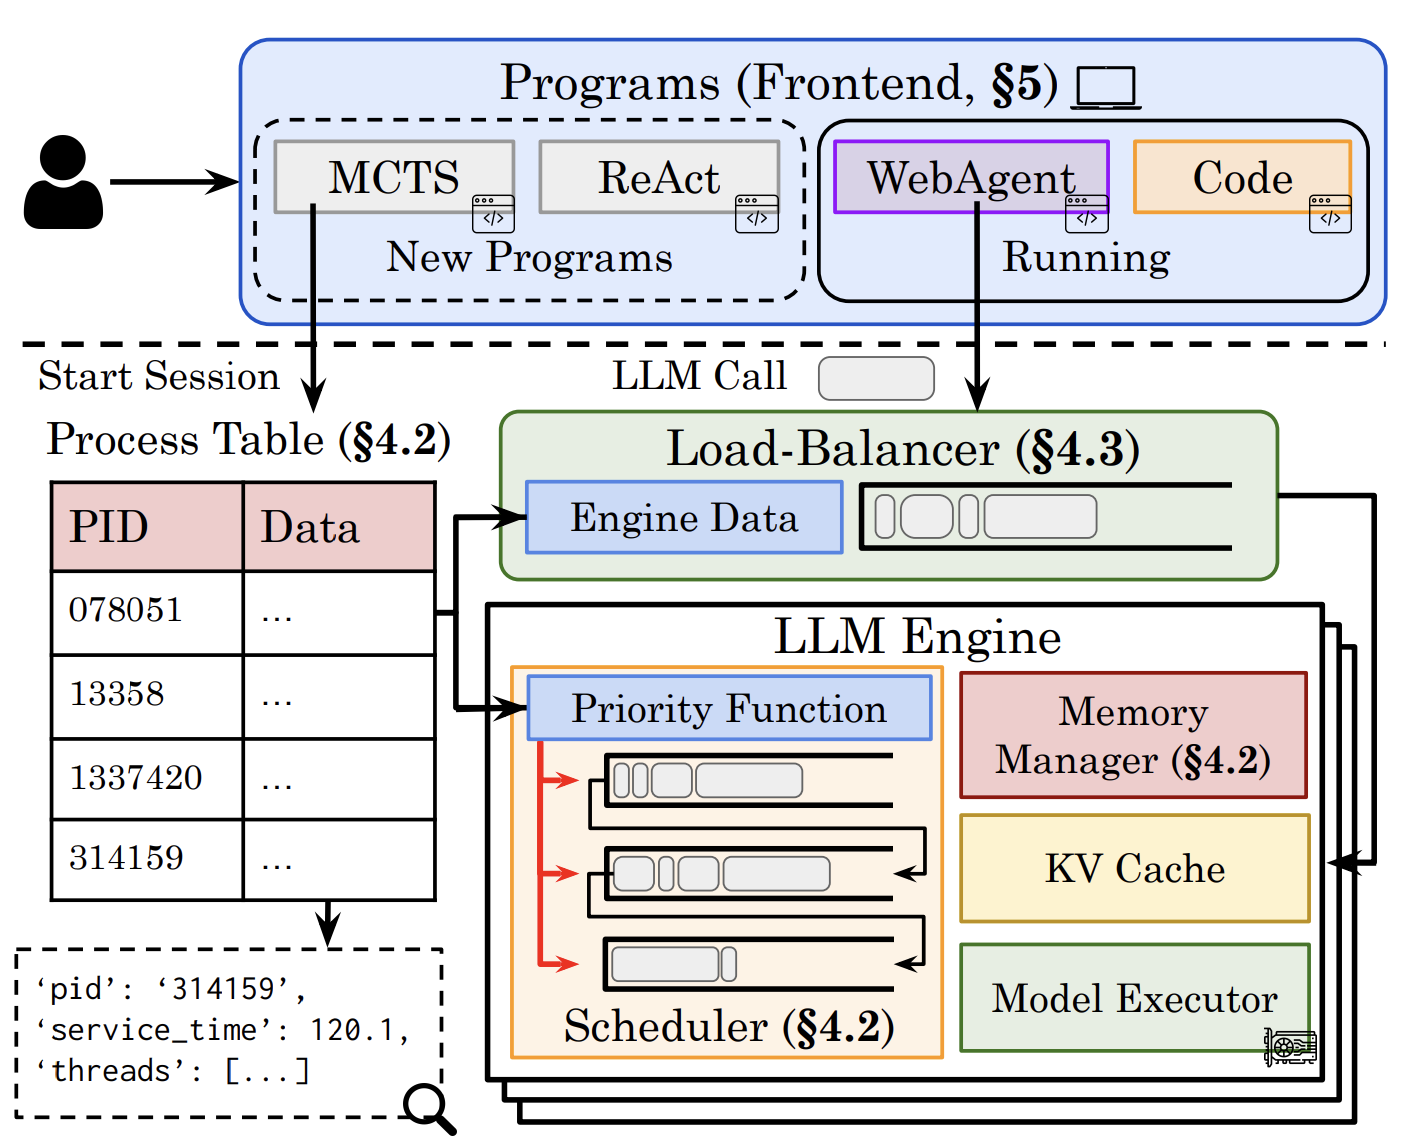
Agentix는 개별 LLM 호출만 보는 대신, 그 호출이 속한 프로그램의 실행 이력까지 함께 고려합니다. 이를 위해 프로그램별 상태를 Global Process Table에 모아 관리해요. 각 프로그램이 지금까지 얼마나 실행되고 기다렸는지, 현재 어떤 Thread가 실행 중인지, 어느 Engine을 사용하고 있는지 같은 정보가 여기에 기록됩니다.
Scheduler는 이 정보를 바탕으로 어떤 프로그램의 LLM 호출에 먼저 실행 기회를 줄지 결정합니다. |
|
|
Agentix의 전체 구조. Agentix는 프로그램별 실행 정보를 Global Process Table에 저장하고, 이를 Scheduler의 Priority Function과 Load Balancer가 함께 활용합니다.
먼저 A1 → A2 → A3 → A4처럼 LLM 호출이 하나의 흐름을 따라 순서대로 이어지는 단일 스레드 프로그램을 생각해보겠습니다. A1과 A2가 끝난 뒤 A3가 새로 들어왔다면, A3만 놓고 봤을 때는 방금 도착한 새로운 호출처럼 보이죠. 하지만 Agentix는 A3만 따로 보지 않고, A3가 속한 Program A가 지금까지 얼마나 실행됐는지까지 함께 봅니다.
이때 사용하는 기준이 PLAS(Program-Level Attained Service)입니다. 여기서 Attained Service는 프로그램이 지금까지 실제로 사용한 실행 시간을 뜻해요. 예를 들어 A1이 2초, A2가 3초 동안 실행됐다면, A3가 들어오는 시점에서 Program A의 Attained Service는 5초입니다. 반면 Program B가 지금까지 1초만 실행됐다면, B의 LLM 호출에 더 높은 우선순위를 주는 식이죠.
PLAS의 아이디어는 간단합니다. 지금까지 덜 실행된 프로그램에 먼저 실행 기회를 주는 것입니다. 앞으로 각 프로그램이 얼마나 오래 실행될지는 알 수 없지만, 지금까지 사용한 실행 시간을 비교하면 긴 프로그램이 후속 호출을 만들 때마다 다시 새로운 작업처럼 높은 우선순위를 얻는 문제를 줄일 수 있습니다.
다만 PLAS는 하나의 프로그램 안에서 LLM 호출이 순서대로 이어지는 경우에 잘 맞습니다. A1 → A2 → A3처럼 앞의 호출이 끝나야 다음 호출이 시작된다면, 앞에서 사용한 실행 시간을 그대로 더하면 프로그램이 지금까지 얼마나 진행됐는지 자연스럽게 나타낼 수 있죠.
하지만 여러 호출이 갈라져 동시에 실행될 수 있는 다중 스레드 프로그램에서는 이야기가 달라집니다. 병렬로 실행된 호출들의 시간을 모두 더하면, 같은 시간에 진행된 작업까지 중복해서 계산하게 되기 때문입니다. 이 경우에는 PLAS처럼 실행 시간을 단순히 누적하는 것만으로는 프로그램의 진행 정도를 제대로 나타내기 어렵습니다.
|
|
|
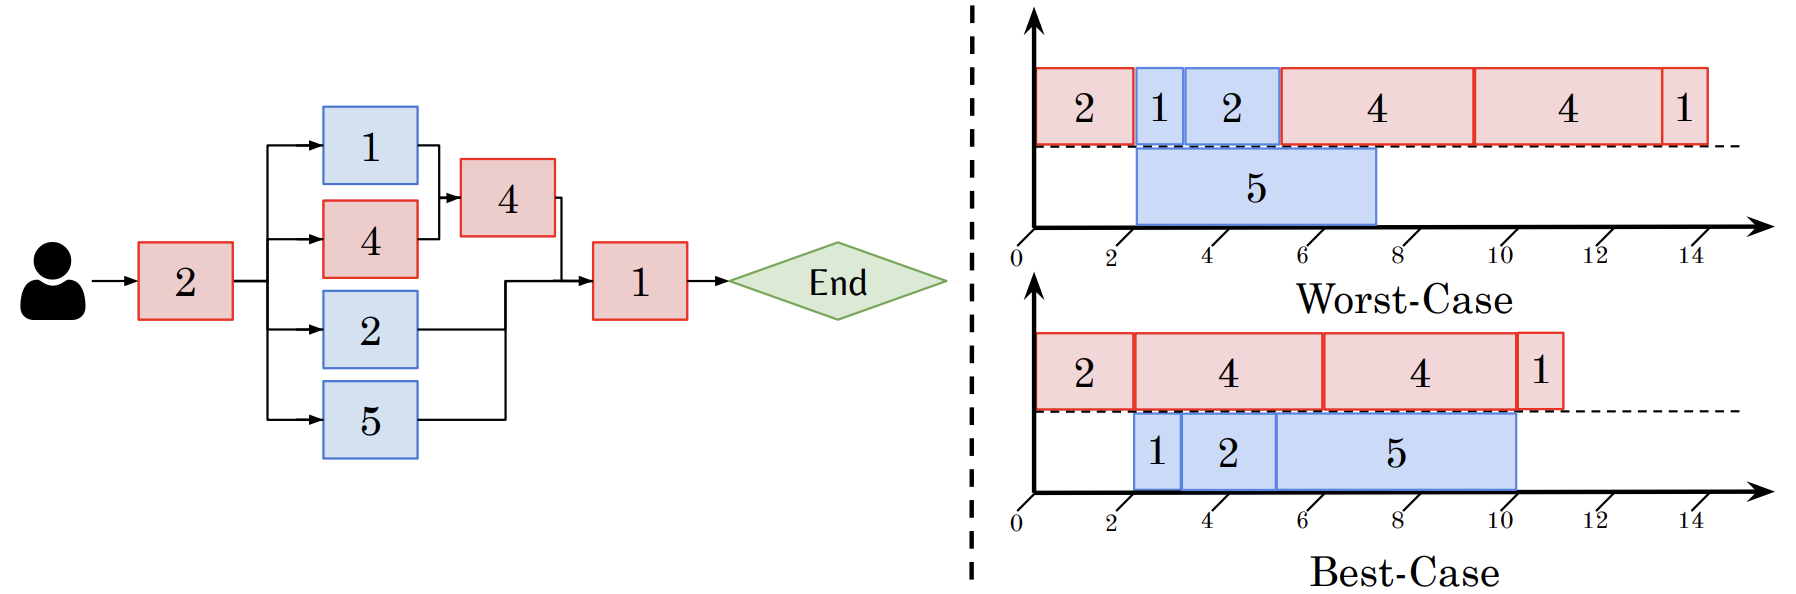
다중 스레드 프로그램에서는 병렬 Branch의 실행 시간을 모두 더하는 대신, 현재까지 관측된 Critical Path를 기준으로 프로그램의 실행 정도를 계산합니다.
그림의 왼쪽을 보면, 하나의 프로그램이 먼저 실행 시간 2의 호출을 수행한 뒤 여러 Branch로 나뉩니다. 이후에는 실행 시간 1, 2, 5의 호출과 4 → 4로 이어지는 호출이 병렬로 진행되고, 마지막에는 다시 실행 시간 1의 호출로 합쳐집니다.
이때 모든 호출의 실행 시간을 단순히 더하면 2 + 1 + 4 + 4 + 2 + 5 + 1 = 19가 됩니다. 하지만 여러 Branch가 동시에 실행될 수 있기 때문에, 프로그램이 실제로 19만큼 진행됐다고 보기는 어렵죠.
그래서 병렬 구조에서는 Critical Path를 기준으로 프로그램의 진행 정도를 봅니다. 그림에서는 2 → 4 → 4 → 1이 가장 긴 경로이고, 길이는 11입니다. 이 경로의 호출들은 순서대로 모두 끝나야 하므로, 다른 Branch를 아무리 잘 병렬로 실행하더라도 프로그램 전체는 최소 11의 시간이 필요합니다.
|
|
|
💡 Critical Path
여러 작업이 병렬로 진행될 때, 전체 프로그램이 끝나는 시점을 결정하는 가장 긴 실행 경로입니다. 이 경로가 늦어지면 다른 Branch가 먼저 끝나더라도 프로그램 전체 완료 시간은 줄어들지 않습니다. |
|
|
Agentix는 이런 다중 스레드 프로그램을 위해 ATLAS(Adaptive Thread-Level Attained Service)를 사용합니다. 모든 호출의 실행 시간을 단순히 더하는 대신, 현재까지 관측된 Critical Path를 기준으로 프로그램이 얼마나 실행됐는지 계산하는 방식입니다.
오른쪽 그림을 보면 왜 이런 기준이 필요한지 더 잘 드러납니다. 같은 프로그램이라도 스케줄링 순서에 따라 전체 완료 시간이 달라질 수 있어요. Best-Case에서는 Critical Path인 2 → 4 → 4 → 1이 끊기지 않고 이어지고, 다른 Branch가 그와 병렬로 처리되면서 프로그램이 11에 끝납니다. 반면 Worst-Case에서는 Critical Path에 속하지 않는 호출들이 먼저 실행되면서 4 → 4 경로가 뒤로 밀리고, 전체 완료 시간도 14까지 늘어납니다.
정리하면, PLAS는 순차적으로 이어지는 프로그램의 누적 실행 시간을, ATLAS는 병렬 구조에서 현재까지 관측된 Critical Path의 실행 시간을 기준으로 우선순위를 정하는 스케줄링 방식입니다. |
|
|
Load-Balancer: 어느 Engine에서 실행할까? |
|
|
앞에서 본 Scheduler가 여러 LLM 호출 중 무엇을 먼저 실행할지 정한다면, Load Balancer는 그렇게 선택된 호출을 어느 LLM Engine에서 실행할지 정합니다.
여러 Engine을 함께 사용할 때는 단순히 가장 한가한 곳으로 보내는 것만으로는 최적이라고 할 수 없습니다. 같은 프로그램의 후속 호출은 이전 대화와 Tool 실행 결과를 이어받기 때문에, 이전에 계산한 KV Cache가 남아 있는 Engine에서 이어서 처리하면 반복 계산을 줄일 수 있기 때문이죠. |
|
|
💡 KV Cache란?
LLM은 입력 Token을 처리하면서, 이후 Token 생성에 필요한 Key와 Value 형태의 중간 계산 결과를 저장합니다. 이를 KV Cache라고 합니다. 같은 Prefix가 다시 등장하면 이 값을 재사용할 수 있어, 이미 처리한 입력을 처음부터 다시 계산하지 않아도 됩니다. |
|
|
이렇게 필요한 데이터가 이미 있는 곳에서 작업을 이어서 실행하는 특성을 데이터 지역성(Data Locality)이라고 합니다. 예를 들어 Program A의 A1을 처리한 Engine에 관련 KV Cache가 남아 있다면, A2나 A3도 같은 Engine에서 처리할 때 이전 계산 결과를 활용할 수 있습니다. 반대로 다른 Engine으로 보내면 같은 Prefix를 다시 계산해야 할 수 있죠.
하지만 모든 후속 호출을 항상 같은 Engine으로 보내면 그곳에 작업이 몰릴 수 있습니다. 그래서 Agentix는 기존 계산을 재사용할지, 더 한가한 Engine으로 보내 작업을 나눌지를 함께 봅니다.
프로그램 초반에는 아직 해당 프로그램만의 Context가 많이 쌓이지 않았기 때문에, 기존 Engine을 고집해서 얻는 이점이 크지 않습니다. 이런 호출은 부하가 낮은 Engine으로 보내는 편이 낫습니다. 반대로 프로그램이 진행될수록 이전 대화와 Tool 결과가 누적되고, 프로그램 고유의 Context도 길어집니다. 이때는 같은 Engine에 남아 있는 KV Cache를 재사용할 수 있는 이점이 커지기 때문에, 이처럼 Context가 길어진 프로그램은 해당 프로그램의 KV Cache가 남아 있는 Engine에서 이어서 처리합니다.
즉 Agentix는 Context가 아직 적을 때는 작업을 여러 Engine에 나누는 쪽을, 많이 누적됐을 때는 기존 KV Cache를 재사용하는 쪽을 더 중요하게 보는 방식입니다. |
|
|
Agent의 작업이 복잡해질수록 Serving도 달라져야 한다 |
|
|
개인적으로 이 논문에서 가장 흥미로웠던 부분은 새로운 스케줄링 알고리즘 자체보다, Serving 시스템이 무엇을 하나의 ‘작업 단위’로 바라봐야 하는지를 다시 생각하게 했다는 점이었습니다. 이렇게 설계한 근거는 사용자의 만족도 측면에서 Chatbot에서는 개별 요청의 지연 시간이 중요했다면, Agent를 사용하는 입장에서는 여러 번의 LLM 호출과 Tool 사용이 모두 끝나 내가 맡긴 작업 전체가 언제 완료되는지가 더 중요하기 때문이죠.
앞으로는 하나의 Agent가 혼자 작업하는 형태를 넘어, 여러 Agent와 사람이 함께 여러 목표를 수행하는 구조도 점점 늘어날 것 같습니다. 그럴수록 Serving은 단순히 GPU를 효율적으로 쓰는 기술이 아니라, Agent 시스템 전체의 성능과 규모를 결정하는 필수적인 기반에 가까워질 것 같습니다. |
|
|
딥 다이브 뉴스레터 잘 보고 계신가요? 여러분의 의견과 피드백을 받습니다 :) |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|