문장 대신 선택과 확률을 내놓는 Jev를 소개합니다. #162 위클리 딥 다이브 | 2026년 9월 23일
에디터 스더리 |
|
|
💡 이번주 뉴스레터에는 이런 내용을 담았어요!
- 언어 모델이 자동화에 쓰일 때 생기는 한계를 정리했습니다.
- 문장 대신 선택과 확률을 내놓는 Jev의 동작 방식을 소개했습니다.
- Jev와 BERT를 비교하며 AI의 역할 분화를 살펴봤습니다.
|
|
|
안녕하세요, 에디터 스더리입니다!
AI에게 일을 시키다 보면, 굳이 이렇게 길게 답할 필요가 있나 싶은 순간이 있습니다. 사실 필요한 것은 몇 가지 선택지 중 하나인데도 언어 모델은 그 선택만 간단히 내놓기보다 질문에 공감하고, 이유를 설명하고, 덧붙일 말까지 챙기며 하나의 답변을 길게 만들어냅니다. 그러면 우리는 그 답변에서 다시 필요한 선택을 골라내야 합니다. 정작 모델이 그 선택을 얼마나 확신하는지는 알기 어렵고요.
그렇다면 처음부터 문장이 아니라, 선택과 그에 대한 확률을 내놓는 모델을 만들면 어떨까요? 최근 이 질문에 답하는 모델이 개발자들 사이에서 큰 주목을 받고 있습니다. 지난 9월 15일 TypeSafe AI가 공개한 Jev입니다. 회사의 공동 창업자 Diogo Almeida는 OpenAI에서 InstructGPT와 RLHF 등 ChatGPT의 기반이 된 연구에 참여했던 연구자인데요. 그는 그 이후로, 대화에서는 이미 사람을 뛰어넘은 언어 모델이 왜 실제 자동화로는 이어지지 못했는지를 고민해 왔다고 합니다. 🤔
|
|
|
TypeSafe AI는 기존 언어 모델이 자동화에 쓰일 때 두 가지 한계에 주목합니다.
첫째는 학습 목표입니다. 지금의 채팅 모델은 RLHF(Reinforcement Learning From Human Feedback)처럼 사람이 더 좋다고 평가한 답변을 내도록 학습합니다. 하지만 모델의 판단대로 시스템이 작업을 실행하려면, 답 자체뿐 아니라 그 판단이 얼마나 확실한지도 알 수 있어야 합니다. 예를 들어 두 선택지 사이에서 모델의 판단이 60 대 40으로 갈린다면, 자동화 시스템에서는 그 불확실성 자체가 중요한 정보가 됩니다. 판단이 애매할 때는 자동으로 실행하지 않고 사람에게 넘길 수 있으니까요.
그렇다면 모델에게 확신도(Confidence)를 함께 출력하라고 하면 되지 않을까요? 문제는 그 숫자를 믿기 어렵다는 점입니다. 모델이 ‘확신도 0.9’라고 답하더라도, 그것은 내부의 확률을 그대로 보여주는 것이 아니라 다른 텍스트와 마찬가지로 그럴듯한 다음 토큰을 생성한 결과에 가깝습니다. 그래서 실제보다 높은 값을 말하거나, 같은 질문에도 다른 숫자를 내놓을 수 있습니다.
모델이 실제로 계산한 확률 분포를 살펴봐도 마찬가지입니다. 사람이 선호하는 답을 내도록 사후학습(Post-training)하는 과정 자체가 모델의 확률 분포를 바꿀 수 있기 때문이죠. 사람들은 대체로 망설이는 답보다 명확하고 자신감 있는 답을 더 높게 평가하고, 이런 선호를 최적화하다 보면 모델이 불확실한 상황에서도 한쪽 답에 과도하게 확신을 싣게 됩니다. 이처럼 여러 답의 가능성 중 일부가 지워지고 확률이 한쪽으로 쏠리는 현상을 Mode Dropping이라고 합니다. 실제로 OpenAI는 GPT-4 기술 보고서에서 사전학습 모델에 비해 사후학습을 거친 모델의 확률 보정(Calibration)이 나빠지는 현상을 보고했습니다. 즉, 문제는 모델이 애초에 신뢰할 수 있는 확률을 내는 것을 목표로 학습된 것이 아니라는 데 있습니다. 대신 사람이 선호하는 답변의 내용과 스타일에 맞추는 데 집중해 왔죠.
둘째는 출력 형식입니다. 언어 모델은 기본적으로 다음 토큰을 하나씩 예측하며 문자열을 만들어냅니다. 형식이 자유로운 덕분에 설명부터 코드, 표까지 다양한 형태의 출력을 만들 수 있지만, 그만큼 소프트웨어가 결과를 바로 사용하기는 어렵습니다. 물론 구조화된 출력(Structured Outputs)이나 함수 호출을 쓰면 원하는 형식의 값을 받을 수 있습니다. 그러나 내부적으로는 여전히 토큰을 하나씩 순서대로 생성하기 때문에, 답이 길어질수록 느려지고 생성한 토큰만큼 비용이 드는 구조는 그대로입니다.
에이전트를 떠올려 보면 문제는 더 분명해집니다. 에이전트가 수행하는 단계 중 상당수는 긴 답변이 아니라 작은 결정으로 이루어져 있기 때문입니다. 다음에 어떤 도구를 사용할지, 작업을 계속할지 멈출지, 요청을 어느 경로로 보낼지 같은 판단을 수없이 반복하는데, 그때마다 문장을 생성하는 모델을 실행하는 셈입니다. 이러한 순간에 필요한 것은 유창한 말보다 빠르고 믿을 만한 판단이 아닐까요?
|
|
|
Jev의 출발점은 단순합니다. 모델에게 무엇을 묻고 어떤 형태로 답할지를 처음부터 정해둡니다. 판단에 필요한 맥락인 State와, 어떤 방식으로 답할지를 정의한 Question을 함께 보내는데요. 질문의 유형은 다음과 같습니다. |
|
|
💡 Jev의 세 가지 기본 요소
- Choice: 주어진 선택지 중 하나를 고릅니다.
예) 이 문의는 결제·기술·계정 중 어느 팀이 맡아야 할까?
- Score: 정해둔 기준표에 따라 상태를 채점합니다.
예) 이 요청의 긴급도는 어느 정도인가? → 0=낮음, 1=보통, 2=높음
- Noul: 어떤 진술이 참일 확률을 0에서 1 사이 값으로 반환합니다.
예) 이 메시지는 환불을 요청하고 있는가? → 0.95
|
|
|
이 질문들에 대한 답은 문장이 아닌, 값과 확률로 돌아옵니다. Choice 질문으로 예를 든다면, Jev는 “이 문의는 결제 팀에서 처리하는 것이 적절해 보입니다” 같은 문장 대신 {결제: 0.6, 기술: 0.4, 계정: 0.0}과 같은 확률 분포를 돌려주는 식입니다. 그다음에 무엇을 할지는 코드가 결정합니다. 확신도가 충분히 높으면 바로 결제 팀으로 보내고, 지금처럼 판단이 갈리면 사람에게 넘기면 됩니다. Jev가 ‘똑똑한 If문(Smart If-statement)’에 비유되는 이유죠.
이 점에서 Jev는 앞서 살펴본 Structured Outputs와도 다릅니다. Structured Outputs가 생성형 언어 모델의 출력을 구조화하는 방식이라면, Jev는 애초에 문장 생성이 아니라 결정 자체를 모델의 기본 과제로 삼습니다. TypeSafe AI는 이러한 모델을 System One Model이라고 부릅니다. |
|
|
💡 System 1 vs. System 2
2002년 노벨경제학상 수상자인 Daniel Kahneman은 대표 저서 『생각에 관한 생각』(원제: Thinking, Fast and Slow)에서 인간의 사고를 두 가지로 구분합니다. 빠르고 직관적인 System 1과, 느리고 숙고적인 System 2로 구분합니다. TypeSafe AI는 여기서 이름을 빌려, 긴 추론보다 짧고 빠른 판단에 초점을 둔 모델을 System One Model이라고 부릅니다. |
|
|
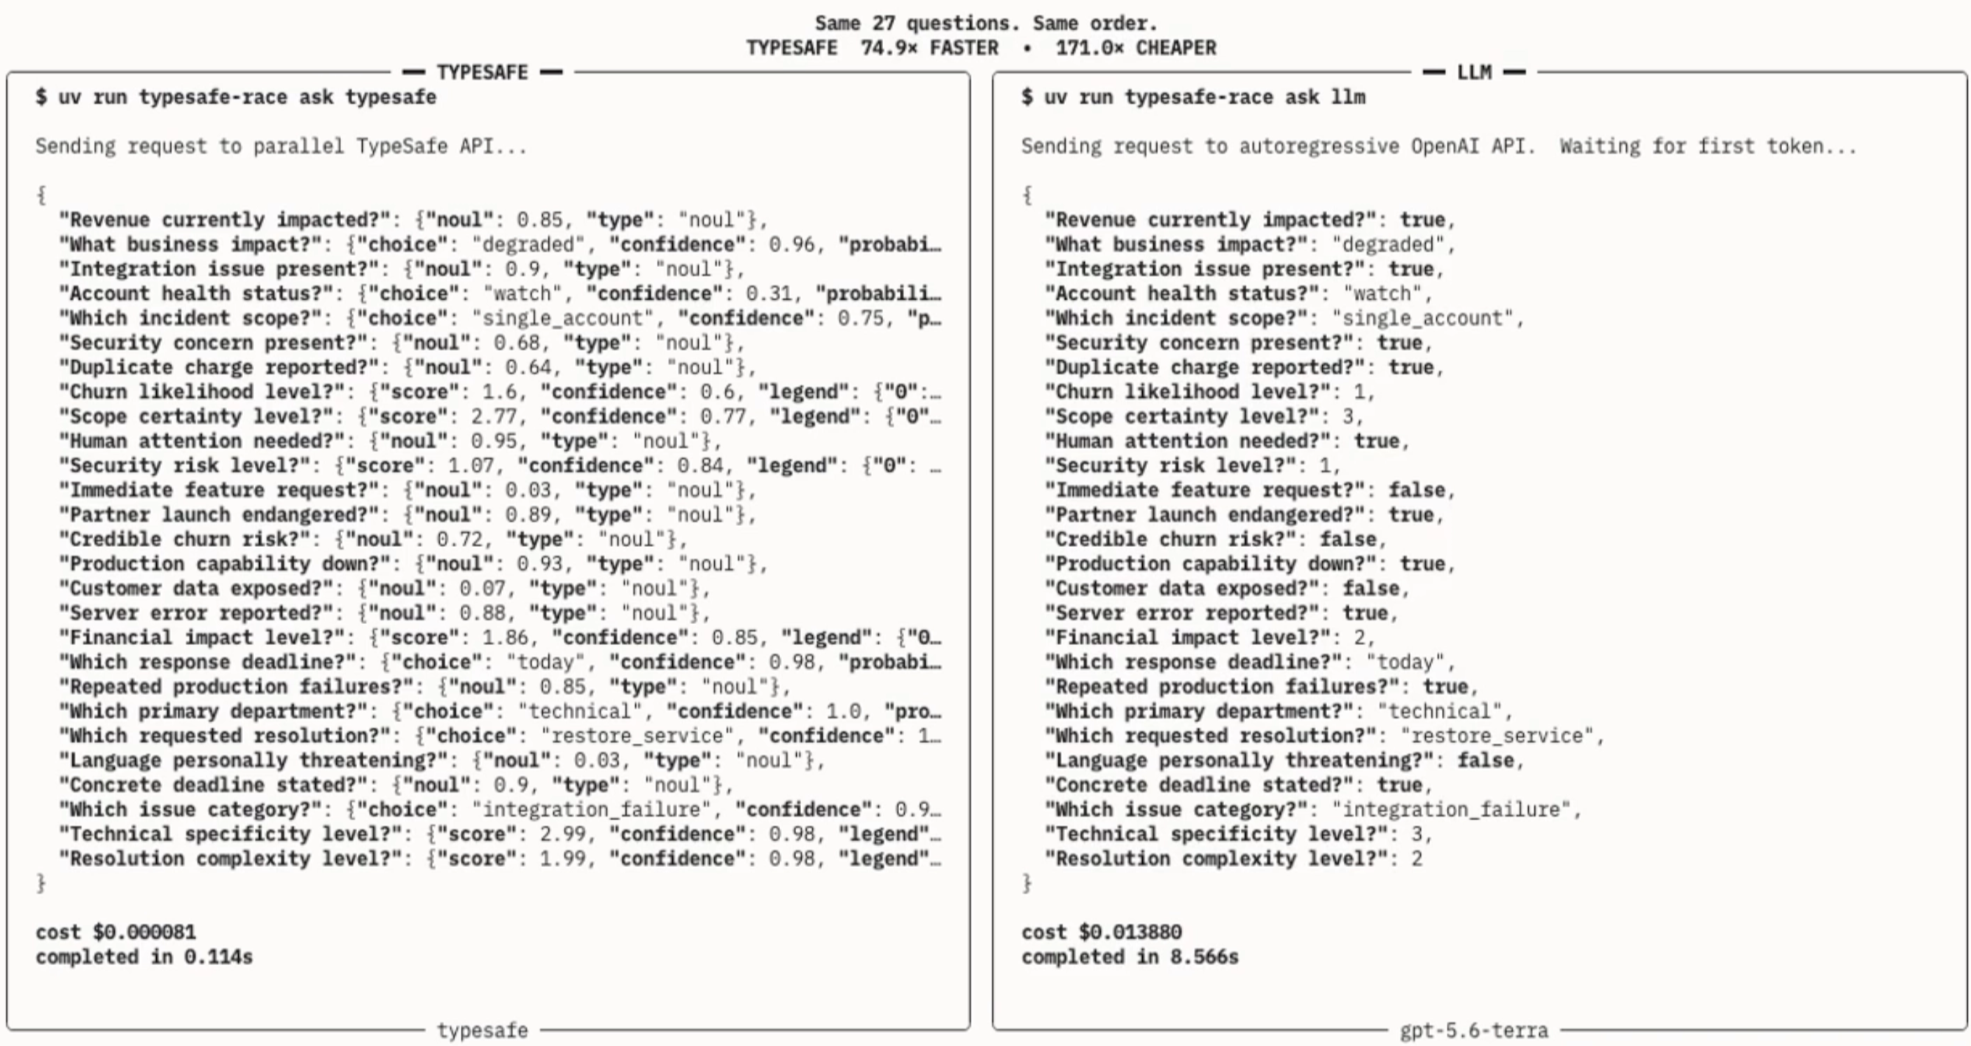
이 구조는 속도와 비용에도 영향을 줍니다. 기존 언어 모델이 토큰을 하나씩 순서대로 생성한다면, Jev는 여러 출력을 한 번의 쿼리에서 병렬로 계산합니다. TypeSafe AI가 공개한 평가에서 Jev의 응답 시간은 약 70~500ms 수준이었고, 비교한 언어 모델들은 수 초에서 수백 초가 걸렸습니다. 같은 유형의 작업에서 수십 배 이상 빠른 것이죠. 문자열을 토큰 단위로 생성하지 않는 구조 덕분에 출력에 대해서는 별도의 토큰 요금도 받지 않습니다. |
|
|
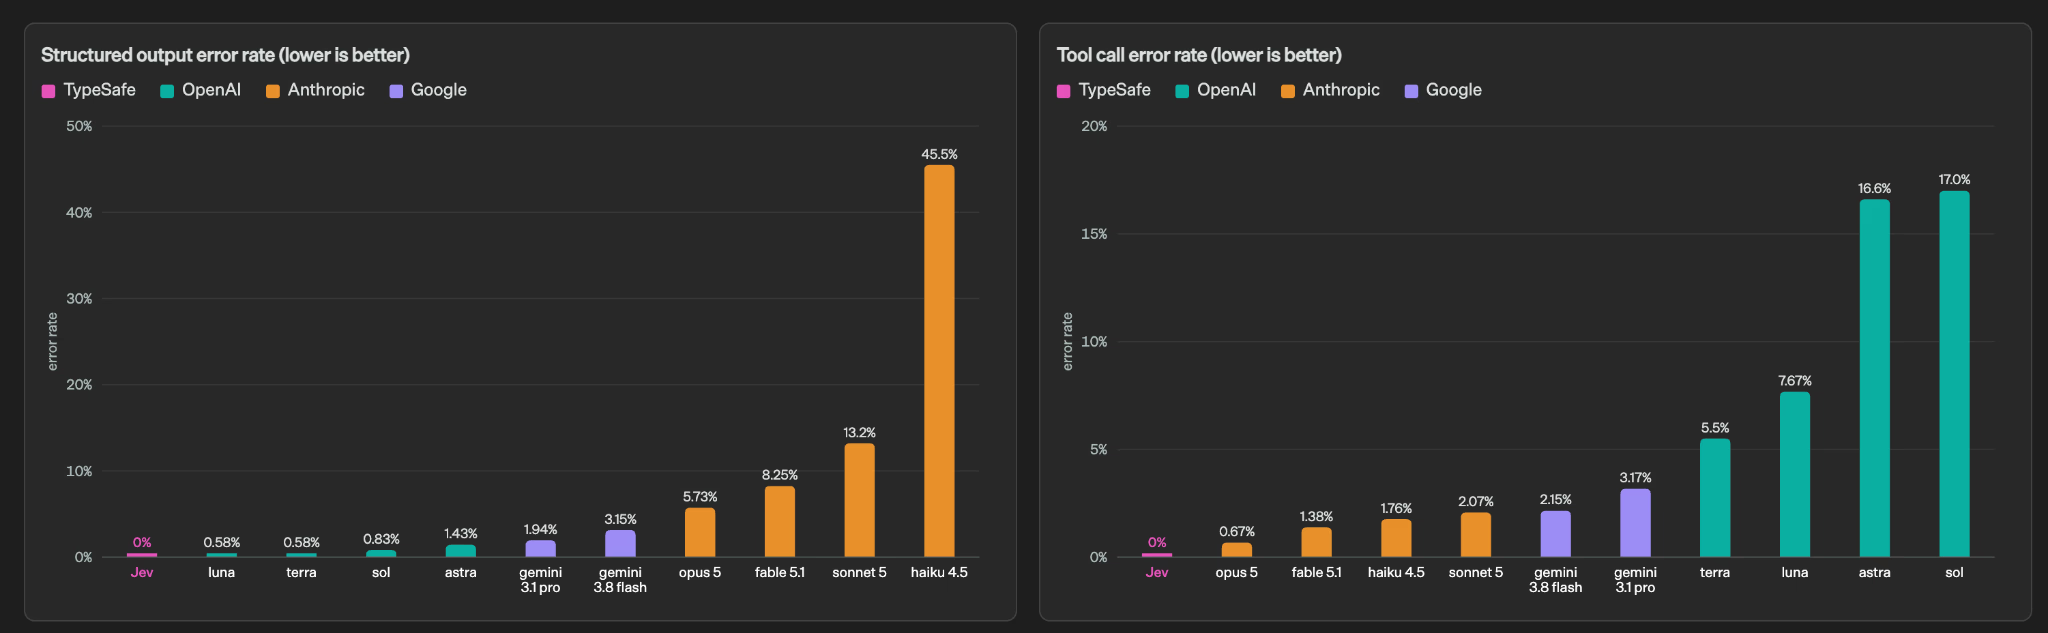
형식이 깨질 걱정도 없습니다. 가능한 답을 미리 정의해두기 때문에, 존재하지 않는 선택지를 새로 만들어내거나 정해둔 스키마를 벗어나는 출력은 구조적으로 막혀 있습니다. TypeSafe AI가 홈페이지에 ‘Zero Hallucinations’라는 문구를 내건 이유이기도 합니다.
|
|
|
다만 이 표현은 조금 조심해서 볼 필요가 있습니다. 정해진 형식을 벗어나지 않는 것과 올바른 판단을 내리는 것은 다른 문제이기 때문입니다. Jev 역시 틀린 선택지에 높은 확률을 줄 수 있습니다. 따라서 ‘Zero Hallucinations’는 Jev가 틀리지 않는다는 뜻이라기보다, 자유로운 문자열 생성에서 발생할 수 있는 유형의 할루시네이션을 구조적으로 차단했다는 의미에 가깝습니다.
그렇다면 이제 더 중요한 질문이 남습니다. Jev가 함께 내놓는 확률은 얼마나 믿을 수 있을까요? 앞서 살펴봤듯, 기존 언어 모델은 애초에 자신의 확률이 실제 정확도와 잘 맞도록 학습된 모델이 아닙니다.
이 문제는 #108에서 다룬 Why Language Models Hallucinate의 문제의식과도 맞닿아 있습니다. 당시 저자들은 ‘모르겠다’고 답하는 것보다 찍어서 맞히는 편이 유리한 평가 체계가 모델의 과신을 부추긴다고 지적했습니다. 그래서 정답만 보상할 것이 아니라, 불확실성을 정직하게 표현하는 것 역시 보상해야 한다고 제안했는데요.
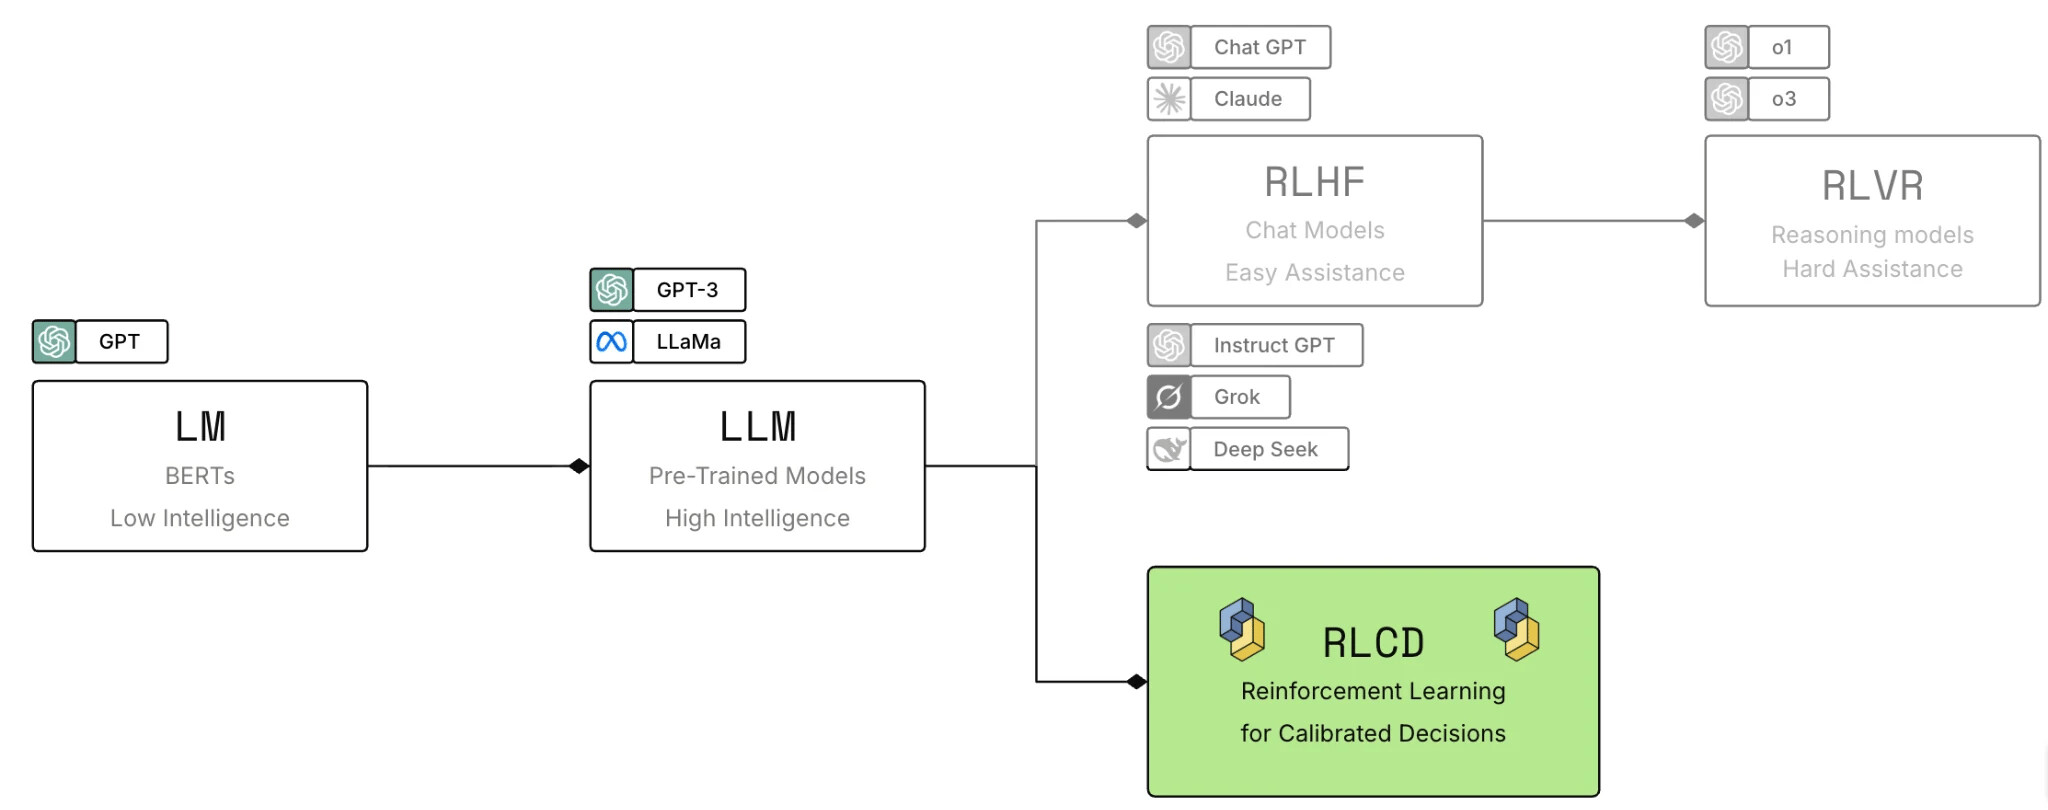
TypeSafe AI는 비슷한 문제의식을 학습 목표 자체에 반영했습니다. RLHF가 ‘사람이 선호하는 응답’을, RLVR(Reinforcement Learning With Verifiable Rewards)이 수학이나 코드처럼 ‘검증 가능한 결과’를 보상한다면, Jev에 사용된 RLCD(Reinforcement Learning For Calibrated Decisions)는 모델이 내놓는 확률이 실제 정확도와 잘 맞도록 학습하는 것을 목표로 합니다. 쉽게 말해 0.8의 확률을 보인 판단들이 실제로도 대략 80% 정도 맞도록 만드는 것입니다.
|
|
|
💡 RLCD(Reinforcement Learning For Calibrated Decisions)란?
RLCD는 모델이 자신의 불확실성을 정직하게 표현하도록 학습하는 것을 목표로 합니다. 이런 학습에 흔히 쓰이는 방법이 Proper Scoring Rule인데요. 틀린 답에 높은 확률을 주면 크게 감점하고, 맞는 답에 지나치게 낮은 확률을 주면 보상을 적게 주는 방식입니다. 그래서 실제로 믿는 만큼의 확률을 말할 때 평균 점수가 가장 높아집니다.
다만 TypeSafe AI는 RLCD의 구체적인 학습 방법을 공개하지 않았기 때문에, Jev가 실제로 이 방식을 쓰는지는 알려지지 않았습니다. |
|
|
이렇게 확률을 믿을 수 있게 되면, 일의 위험도에 따라 자동 처리 기준을 다르게 둘 수 있습니다. 고객 문의를 담당 팀에 배정하는 일은 확률이 0.7만 넘어도 자동으로 처리하고, 되돌리기 어려운 환불 승인은 0.95를 넘을 때만 처리하는 식이죠. 위험을 얼마나 감수할지를 코드의 숫자 하나로 정하는 것입니다.
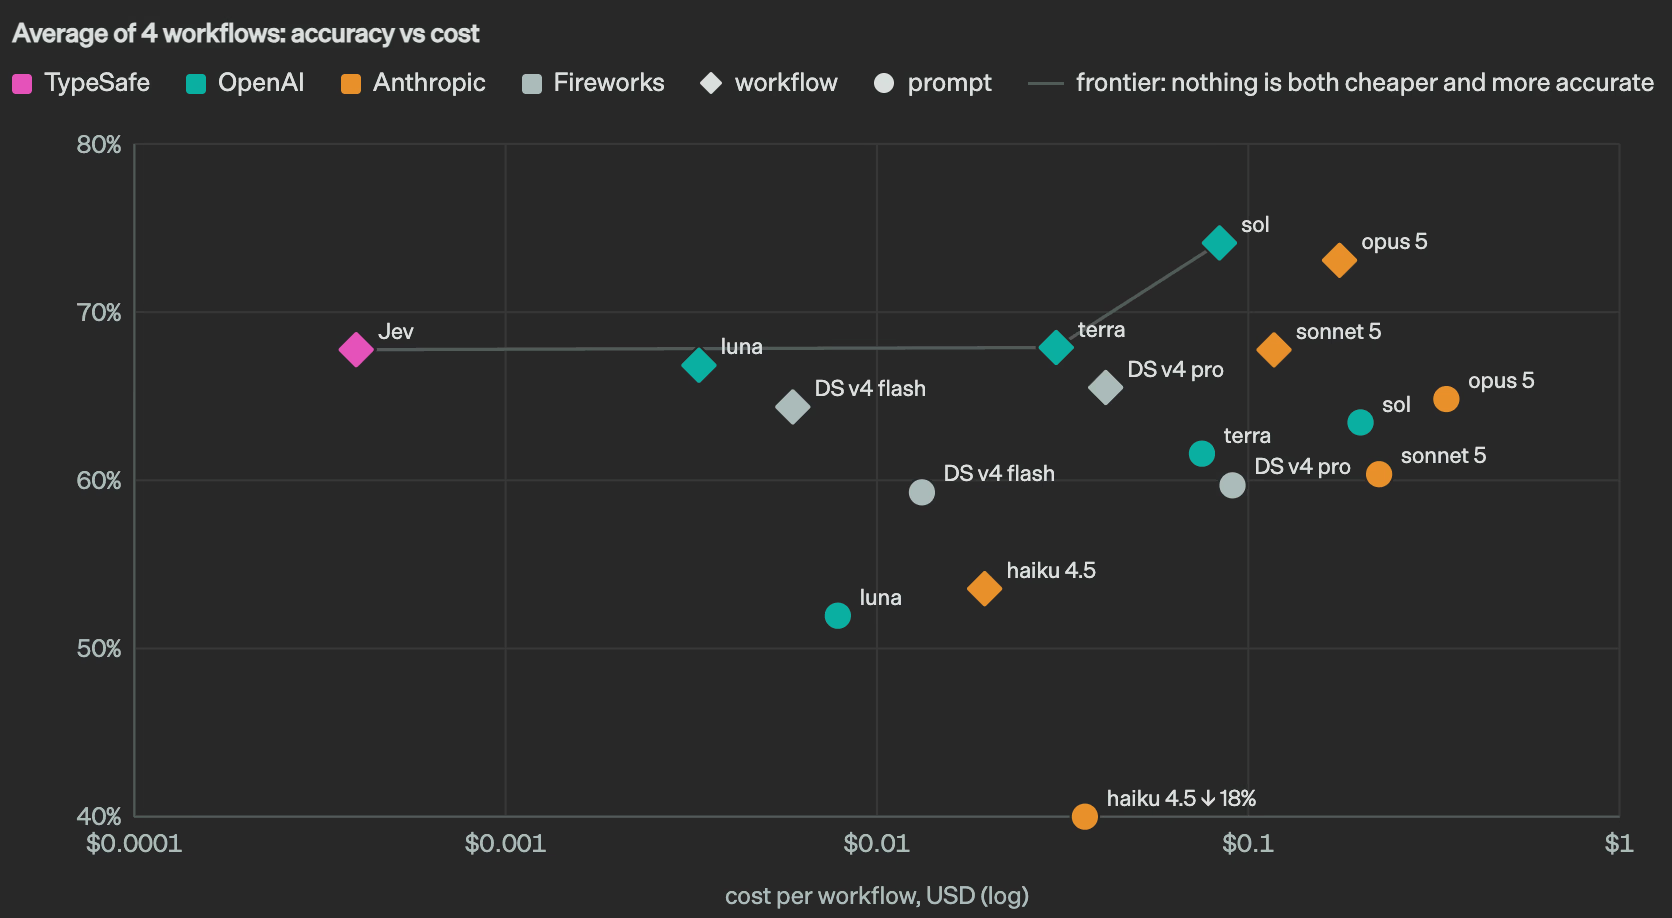
그렇다고 Jev가 가장 똑똑한 모델인 것은 아닙니다. TypeSafe AI가 최상위 언어 모델들의 판단을 기준으로 네 가지 실무 워크플로우를 평가한 결과, Jev의 평균 정확도는 67.8%였고 일부 워크플로우에서는 다른 언어 모델보다 눈에 띄게 낮았습니다. 대신 비용은 수백분의 1, 응답 시간은 수십분의 1 수준이었죠. Jev의 강점은 최고의 정답 하나를 내놓는 데 있다기보다, 충분히 좋은 판단을 매우 낮은 비용과 짧은 지연으로 반복하는 데 있습니다. |
|
|
물론 한계도 분명합니다. TypeSafe AI가 직접 공개한 약점 목록에 따르면, Jev는 개수를 세거나 날짜를 비교하는 데 약하고, 여러 단계를 거치는 추론도 잘 하지 못합니다. 입력 안에 심어둔 지시에 판단이 흔들릴 수 있다는 점도 주의해야 합니다.
공개 직후부터 독립적인 평가도 나오기 시작했습니다. 지금까지는 속도와 비용에서는 일관된 강점이 보이지만, 정확도와 확률 보정은 과제에 따라 결과가 엇갈립니다. 아직 평가 규모가 작고 기술 보고서도 공개되지 않은 만큼, Jev의 강점이 어디까지 일반화되는지는 조금 더 지켜볼 필요가 있습니다.
|
|
|
Jev에 대한 반응은 뜨거웠습니다. Vercel은 Jev가 자사 AI Gateway 역사상 첫 24시간 동안 가장 빠르게 채택된 모델이라고 밝혔고, 공개 일주일 만에 Jev와 같은 방식으로 동작하는 오픈소스 모델도 여럿 등장했습니다.
이렇게 비슷한 모델들이 빠르게 나올 수 있었던 건, Jev의 방식이 완전히 낯선 것만은 아니기 때문이기도 합니다. 텍스트를 읽고 정해진 선택지 중 하나를 고르는 방식은 생성형 AI 이전에도 널리 쓰였으니까요. 대표적인 예로 문장을 읽고 감정이나 주제를 분류하던 BERT가 있습니다.
흥미롭게도 공개 직후 등장한 오픈소스 모델 Laya는 실제로 ModernBERT 계열 인코더 위에 Jev와 비슷한 Choice·Score·Noul 인터페이스를 구현했습니다. Jev의 내부 구조는 공개되지 않았지만, 적어도 이런 종류의 결정 모델이 반드시 생성형 LLM 구조를 필요로 하는 것은 아니라는 점을 보여줍니다.
그렇다면 Jev는 정말 과거의 분류 모델로 돌아간 것일까요? 겉모습은 닮았지만 결정적인 차이가 있습니다. BERT로 고객 문의를 분류하려면 레이블 달린 데이터를 모으고, 태스크마다 모델을 파인튜닝해야 했습니다. 선택지가 하나만 바뀌어도 다시 학습해야 했죠. 반면 Jev는 질문과 선택지를 요청할 때마다 자연어로 정의합니다. 추가 학습 없이 새로운 판단 문제를 바로 풀 수 있다는 점에서, 입력만큼은 분명히 지시를 따르는 언어 모델의 유산을 물려받은 것이죠.
|
|
|
Jev는 언어 모델을 대체하기 위한 모델이 아닙니다. TypeSafe AI 역시 Jev가 판단하고 분류하는 일에는 맞지만, 글을 쓰거나 대화를 나누는 일에는 맞지 않는다고 설명합니다.
오히려 Jev가 흥미로운 이유는 AI 시스템이 역할에 따라 분화될 가능성을 보여준다는 데 있습니다. 확실한 규칙은 코드가, 규칙으로 정하기 애매한 짧은 판단은 Jev 같은 결정 모델이, 긴 추론과 글쓰기는 생성 모델이 맡는 식입니다.
TypeSafe AI가 공개한 스마트홈 어시스턴트 데모도 이 구조를 보여줍니다. "집 안의 모든 조명을 꺼줘"라는 요청이 들어오면 Jev가 요청의 종류와 대상 공간, 기기 종류를 한 번에 판단해 바로 실행하고, 한 문장에 여러 명령이 섞여 있거나 일상적인 대화일 때만 생성형 언어 모델에게 넘깁니다.
저는 Jev가 과거로의 회귀라기보다 나선형 진화에 가깝다고 생각합니다. 정해진 선택지 중 하나를 고른다는 점에서는 BERT가 있던 자리로 돌아온 것처럼 보이지만, 이제는 새로운 질문도 추가 학습 없이 바로 이해하고 판단할 수 있으니까요. 비슷한 자리로 돌아온 듯 보여도, 그 사이 언어 모델이 쌓아온 범용성만큼 한 층 올라선 셈입니다.
모든 일을 말로 풀던 AI가, 이제는 말하지 않아도 되는 자리를 찾아가고 있는지도 모르겠습니다.
|
|
|
딥 다이브 뉴스레터 잘 보고 계신가요? 여러분의 의견과 피드백을 받습니다 :) |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|