Anthropic의 주간 이슈와 Self-evolving 모델의 특징을 알아봅니다. #161 위클리 딥 다이브 | 2026년 9월 16일
에디터 배니 |
|
|
💡 이번주 뉴스레터에는 이런 내용을 담았어요!
- Anthropic이 한 주 동안 겪은 AI Safety 이슈를 요약했습니다.
- Self-evolving의 단계와 원리를 정리했습니다.
- OpenAI의 Hugging Face 해킹 사건을 소개했습니다.
|
|
|
안녕하세요, 에디터 배니입니다.
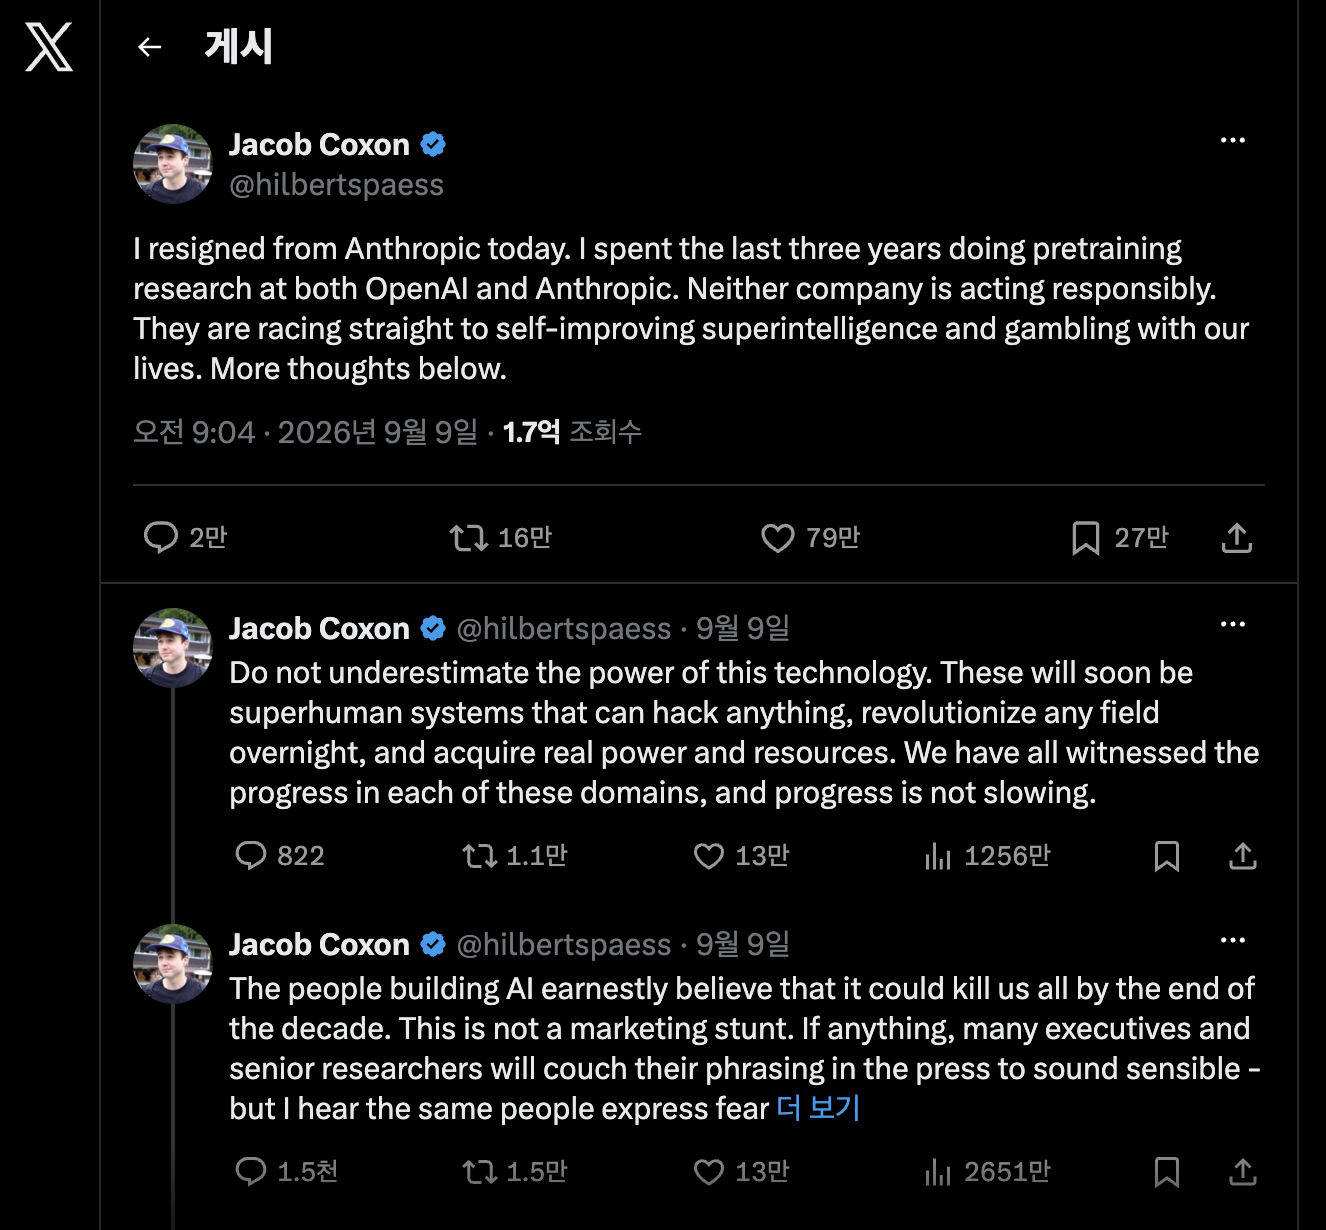
지난 9일, Anthropic에서 일하던 Jacob Coxon은 “AI가 10년 안에 인류를 멸망시킬 수도 있다”고 경고하며 퇴사했습니다. 그는 OpenAI와 Anthropic에서 모델 사전 학습을 담당했는데요. AI 개발이 가속화되고 있지만, 안정성은 그만큼 고려하고 있지 않다고 주장합니다. 문제는 다른 동료들도 이에 크게 반박하지 않았다는 점입니다. 이 트윗은 국내 언론사뿐만 아니라 외신들도 비중있게 다루며 1.7억 조회수를 달성했습니다.
|
|
|
Anthropic은 지난 10일, AI의 오용(Misuse)에 사례를 발간하며 러시아의 해킹 조직이 외교 기관을 공격하거나, 중국 AI 기업들이 Claude 대화 1억 5100만여 건을 무단 수집하며 불법적으로 증류한 사실을 밝혔습니다. 그밖에도 AI로 무기를 설계하거나, 표적 감시, 선전 등에도 활용했다고 보고하며 AI가 불러올 수 있는 위험성을 환기시켰죠.
그리고 지난 12일, Anthropic의 대표인 다리오 아모데이는 <We Must Pace the Frontier> 에세이를 포스팅하며 AI의 위험성에 대해 경고하고 AI 개발 속도를 늦추자는 메시지를 던졌습니다. OpenAI의 샘 올트먼, Tesla의 CEO 일론 머스크 등 세계 AI 업계 수장들도 이 경고에 동의했습니다.
이 모든 사건이 불과 일주일 사이에 벌어진 일입니다. 보통은 기술이 발전하면서 기술 인지도와 수용도가 높아지고, 자연스레 과도한 우려나 음모론은 줄어들게 마련입니다. 그러나 오히려 기술 발전 속도가 너무 빨라서 AI를 개발하는 기업조차 우려를 표하고 있으니, 당면한 상황만 보자면 전 인류가 눈에 보이지 않은 위험에 처한 것은 사실인 듯합니다.
불편한 진실입니다. AI로 자동화가 가능하다는 것은, 다시 말하면 AI가 인간의 통제밖에 놓여도 ‘스스로’ 움직일 수 있다는 것인데요. 솔직히 AI 에이전트 엔지니어링을 하다보면 AI가 되묻는 것조차 귀찮아서 모든 권한을 부여한 적도 있습니다. 당장 큰일이 나진 않겠지만, 이러한 안전불감증 하에 개인정보가 유출되거나 중요한 암호키가 유출되는 등 크고 작은 문제들이 이미 발생했습니다. 중요한 문제이지만, AI의 편리함을 깨달아버린 인간이 시대를 역행하기는 어려워 보입니다.
그래서 AI 수장들이 내놓은 답은 AI 개발을 늦추는 것입니다. 뒤로 갈 수는 없으니, 앞으로 가는 속도를 늦추는 것이죠. 다리오 아모데이는 자신의 블로그에서 AI가 스스로 학습하는 능력, 즉 AI 학습이 RSI(Recursive Self-Improvement)의 초기에 진입했다고 점을 지적했습니다. RSI는 이름 그대로 ‘재귀적 자기 개선’이라는 뜻으로 AI가 스스로 생성한 결과물을 피드백하며, 자신의 코드를 수정하거나 능력을 발전시키는 과정을 의미합니다.
이 기술의 정체는 무엇일까요? 이번주 뉴스레터에서는 AI가 스스로 진화하는 능력, Self-evolving 연구 사례를 살펴보며 기술의 위험성을 함께 짚어보도록 하겠습니다.
|
|
|
지난 6월, Anthropic은 자사 블로그에 <When AI builds itself> 리포트를 공개했습니다. 이는 AI가 개발한 AI의 성능이 어떻게 달라졌는지 분석한 글입니다. 이제 AI 개발자들조차 AI 개발 코드를 스스로 작성하지 않습니다. 이미 AI가 충분히 ‘좋은 코딩(Good code)’을 할 수 있기 때문입니다. 여기에는 두 가지 의미가 모두 담겨 있습니다. 제대로 작동하고, 그 코드가 다른 개발자가 읽었을 때도 이해하기 쉽다는 것입니다.
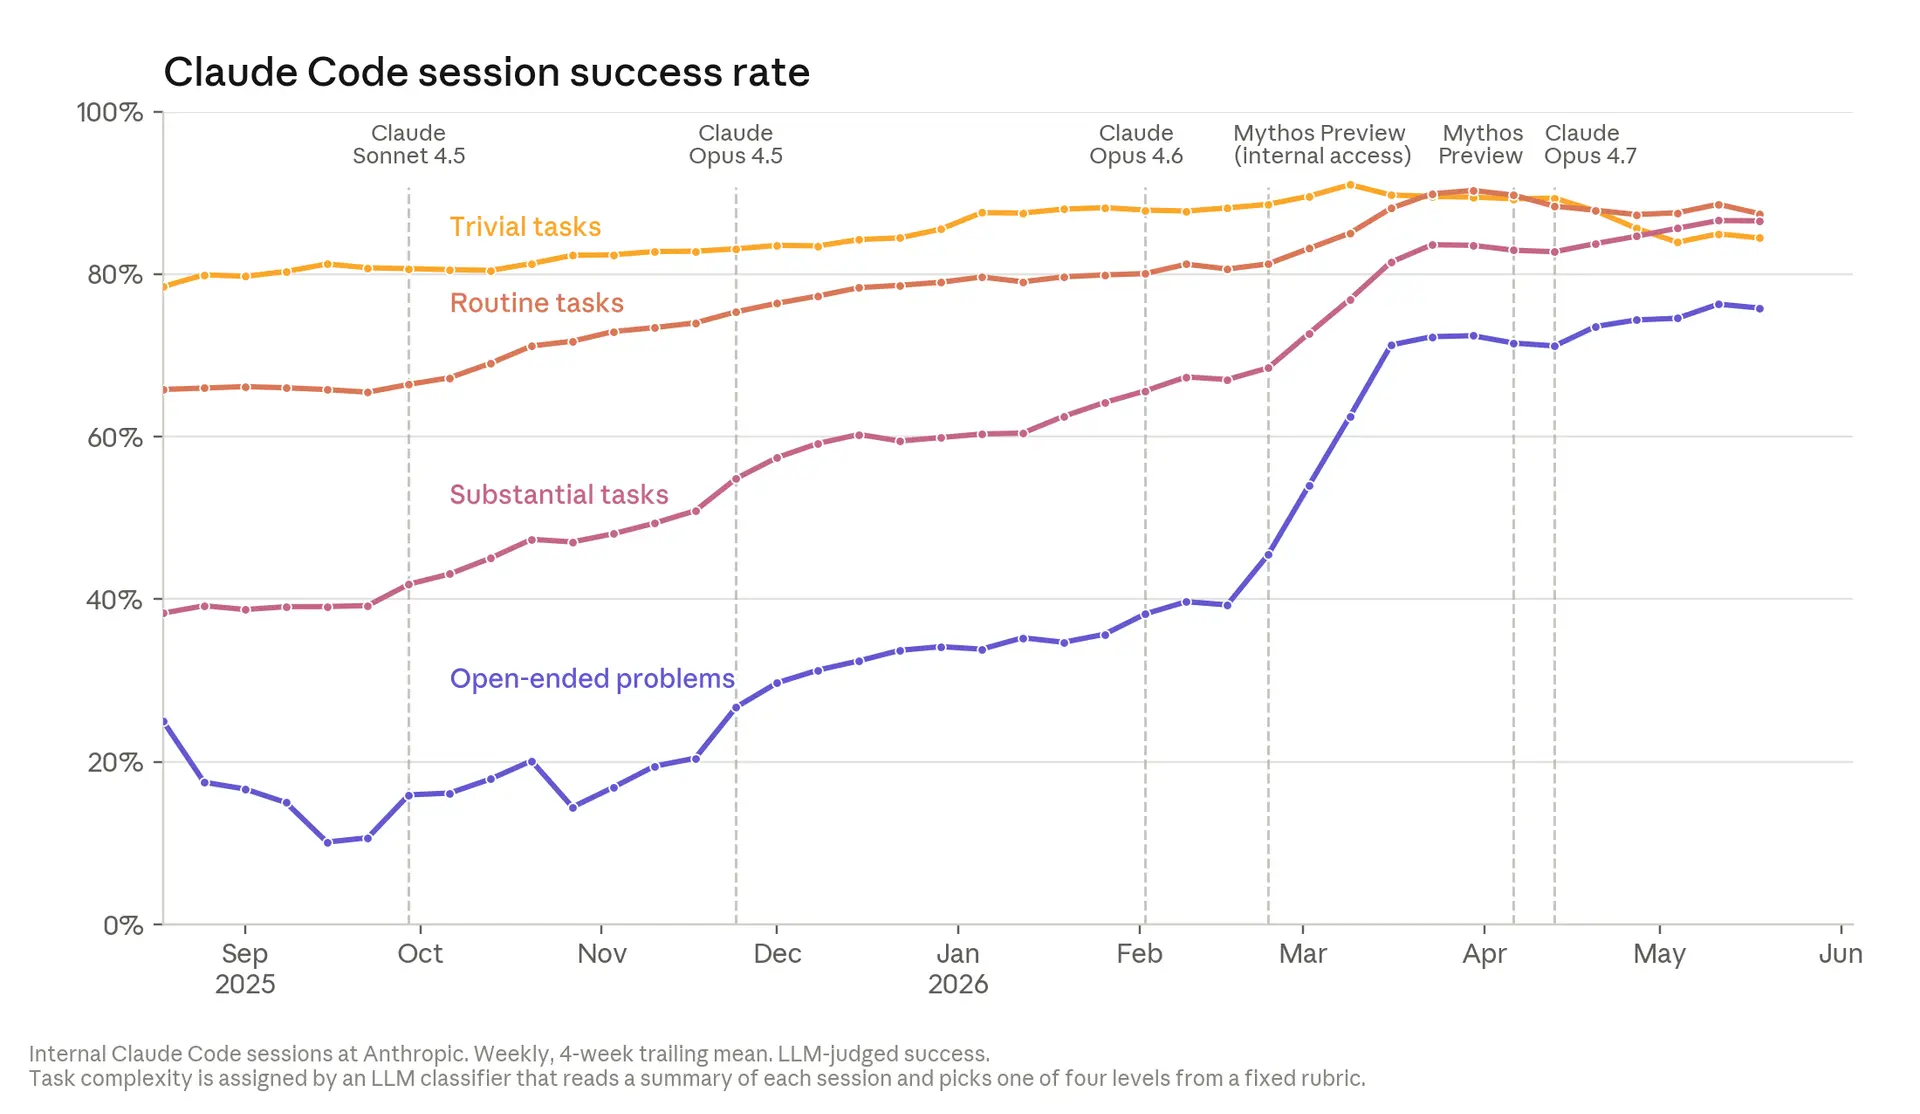
올해 5월에 Anthropic의 코드베이스에 병합(Merge)된 코드의 80%가 Claude가 작성했다고 말합니다. 과거에는 그래도 AI가 생성한 코드를 이어받아 수정하는 사례가 더 많았는데, 이제는 상황이 반대가 된 것입니다. 오히려 인간 개발자들이 만든 코드를 AI가 수정하는 사례도 나타나고 있고요. 아시다시피 Anthropic에는 세계 최고 수준의 개발자들이 일하고 있는 데도 말이죠.
|
|
|
게다가 엔지니어조차 정답을 알지 못하는 열린 질문(Open-ended Question)에서도 AI의 성공률은 6개월만에 50%p가 올라 76%에 달합니다. 그 외의 태스크는 이미 그 수준을 상회하고 있고요. 인간이 해야 할 일은 이제 무엇을 할지 결정하고, 리뷰하는 것 정도에 불과합니다.
이미 Anthropic은 인간의 능력을 뛰어 넘은 AI 모델을 보유하고 있고, AGI를 향해 달릴 준비가 되어 있다는 사실을 보여줍니다. Anthropic의 진의를 파악하기 어렵지만 지속적으로 AI 모델의 자동화의 위험성을 우려하며 발전 속도를 늦추고 템포를 조절해야 한다고 주장한 것은 사실입니다. 그러나 사기업의 특성상 현실적으로 불가능에 가까운 선택지에 가까워보입니다.
|
|
|
Anthropic의 보고서는 이미 AI가 인간의 능력을 넘어섰고, 오히려 인간이 AI 개발의 병목이라는 점을 보여줍니다. Anthropic은 다른 AI 기업들과 마찬가지로 이 기술의 정체를 상세하게 공개하고 있지 않습니다. 하지만 유사한 연구는 기업 밖에서도 계속해서 이루어지고 있습니다. AI가 스스로 문제점을 개선하고 발전하도록 학습하는 방법을 Self-evolving이라고 합니다.
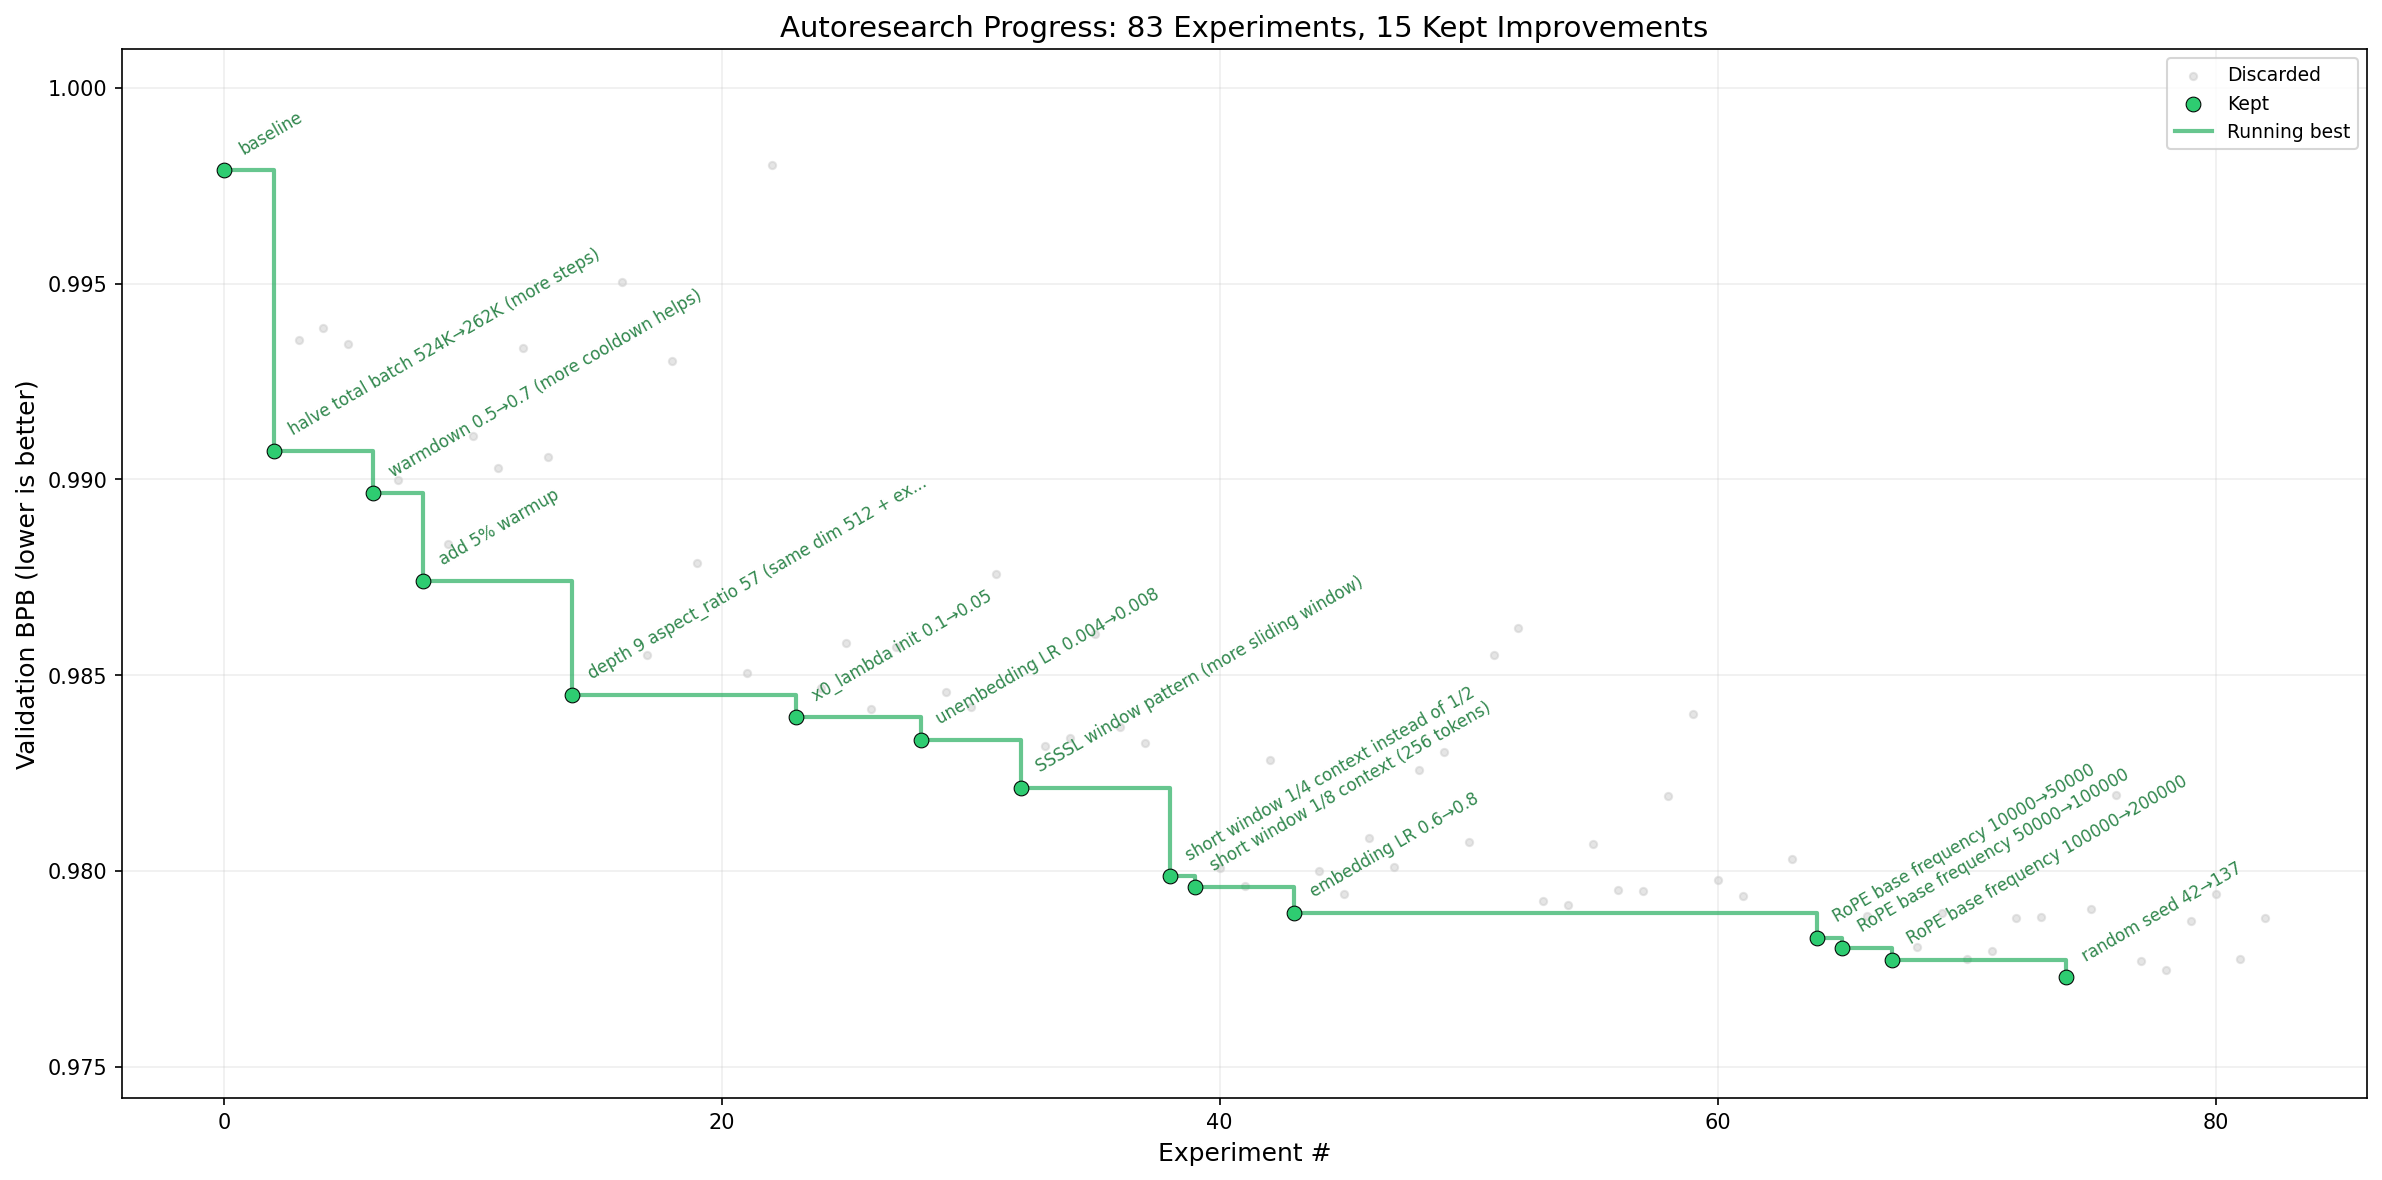
AI의 석학으로 꼽히는 안드레이 카파시는 지난 3월, 자신의 GitHub에 Autoresearch 레포지토리를 공개했습니다. 실제로 AI가 스스로 성능을 개선할 수 있도록 실험 계획을 세우고 반복할 수 있도록 만든 것인데요. AI 연구자들은 연구 성과를 위해 벤치마크 성능을 높이고자 다양한 실험 계획을 수립하고, 수정합니다. 보통 좋은 가설을 세우더라도 실제로 유효한 경우는 많지 않아 기존 가설을 폐기하고, 새로운 가설을 세우며 실험을 반복하죠.
안드레이 카파시는 AI에게 실험할 수 있는 환경을 제공하고, 연구자들이 연구하는 과정을 AI가 스스로 반복하도록 만들었습니다. 그가 제공한 것은 단 4가지입니다. 지침, 데이터 전처리와 실행에 필요한 코드, 학습 모델 코드, 그리고 환경을 구성한 패키지입니다. 실제로 AI가 수정할 수 있는 것은 학습 모델 코드(train.py)뿐입니다. 인간이 실험 지침만 내리면 되죠.
|
|
|
이 실험에는 매 5분 동안, 한 시간에 12번씩 코드를 수정하도록 만들었습니다. 그러면 잠들어 있는 동안 약 100번 정도 수정할 수 있죠. 실제로 83번의 실험에서 총 15번의 개선점이 나타나며, 모델의 성능을 소폭 개선했습니다. 물론, 반드시 Autoresearch가 아니더라도 하이퍼파라미터 튜닝이나 AutoML과 같이 기존의 방법으로도 충분히 이 정도의 개선을 이끌어낼 수 있습니다. 그러나 단순히 여러 후보 옵션을 반복한 것이 아니라, ‘스스로’ 좋은 옵션을 찾았다는 것은 분명 모델의 성능 개선이 어느 정도 자동화될 수 있는 것을 보여줍니다.
사실, 이 사례가 정확히 Self-evolving을 의미하진 않습니다. AI 에이전트가 자신의 성능을 개선하기 위해 자기 자신을 수정한 것이 아니기 때문입니다. 다만, AI 에이전트가 다른 AI 모델의 성능을 개선할 수 있다는 가능성을 보여준 것이죠. 안드레이 카파시는 “이 과정을 반복한다면 가장 빠른 연구 성과를 만드는 연구 조직 단위의 코드를 찾는 것이 자명하다”고 밝혔습니다. 이 과정을 반복하는 주체가 AI 에이전트라면 비로소 Self-evolving이라고 할 수 있습니다.
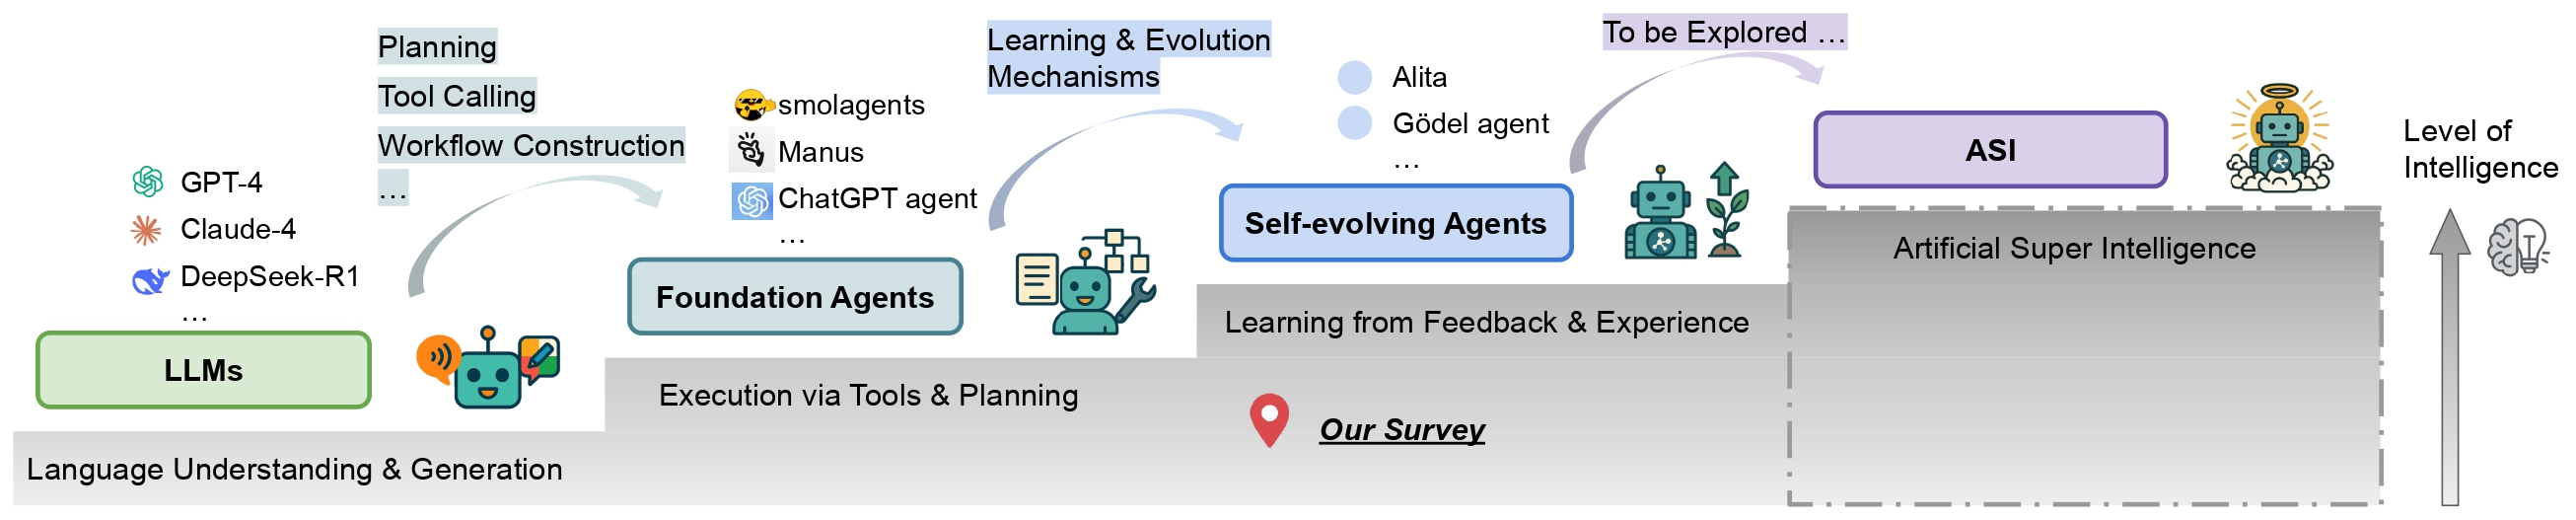
최근 Self-evolving의 구조는 단일 모델로 이루어지기보다, 에이전트 시스템 내에서 이뤄집니다. 지난해 7월 공개된 <A Survey of Self-Evolving Agents> (Gao et al., 2025)에서는 Self-evolving의 층위를 크게 1) 메모리 2) 도구/스킬 3) 가중치 4) 코드 4가지로 구분합니다.
이미 2024년부터 상용 AI 서비스에도 메모리 단위 업데이트가 지원됐고, 이제 사람마다 맞춤형 AI 서비스를 제공받고 있습니다. 사람이 직접 메모리를 업데이트하지 않아도 알아서 기억해야 하는 정보를 추출하고 업데이트하죠. 도구나 스킬도 마찬가지입니다. 에이전트가 사용 빈도가 늘어나면서 이제 단번에 성능을 끌어올리기 위해 외부 도구나 스킬을 사용해야 하는 경우도 같이 늘어났는데요. 이때 에이전트 모델이 스스로 필요한 도구와 스킬을 불러오는 것입니다.
|
|
|
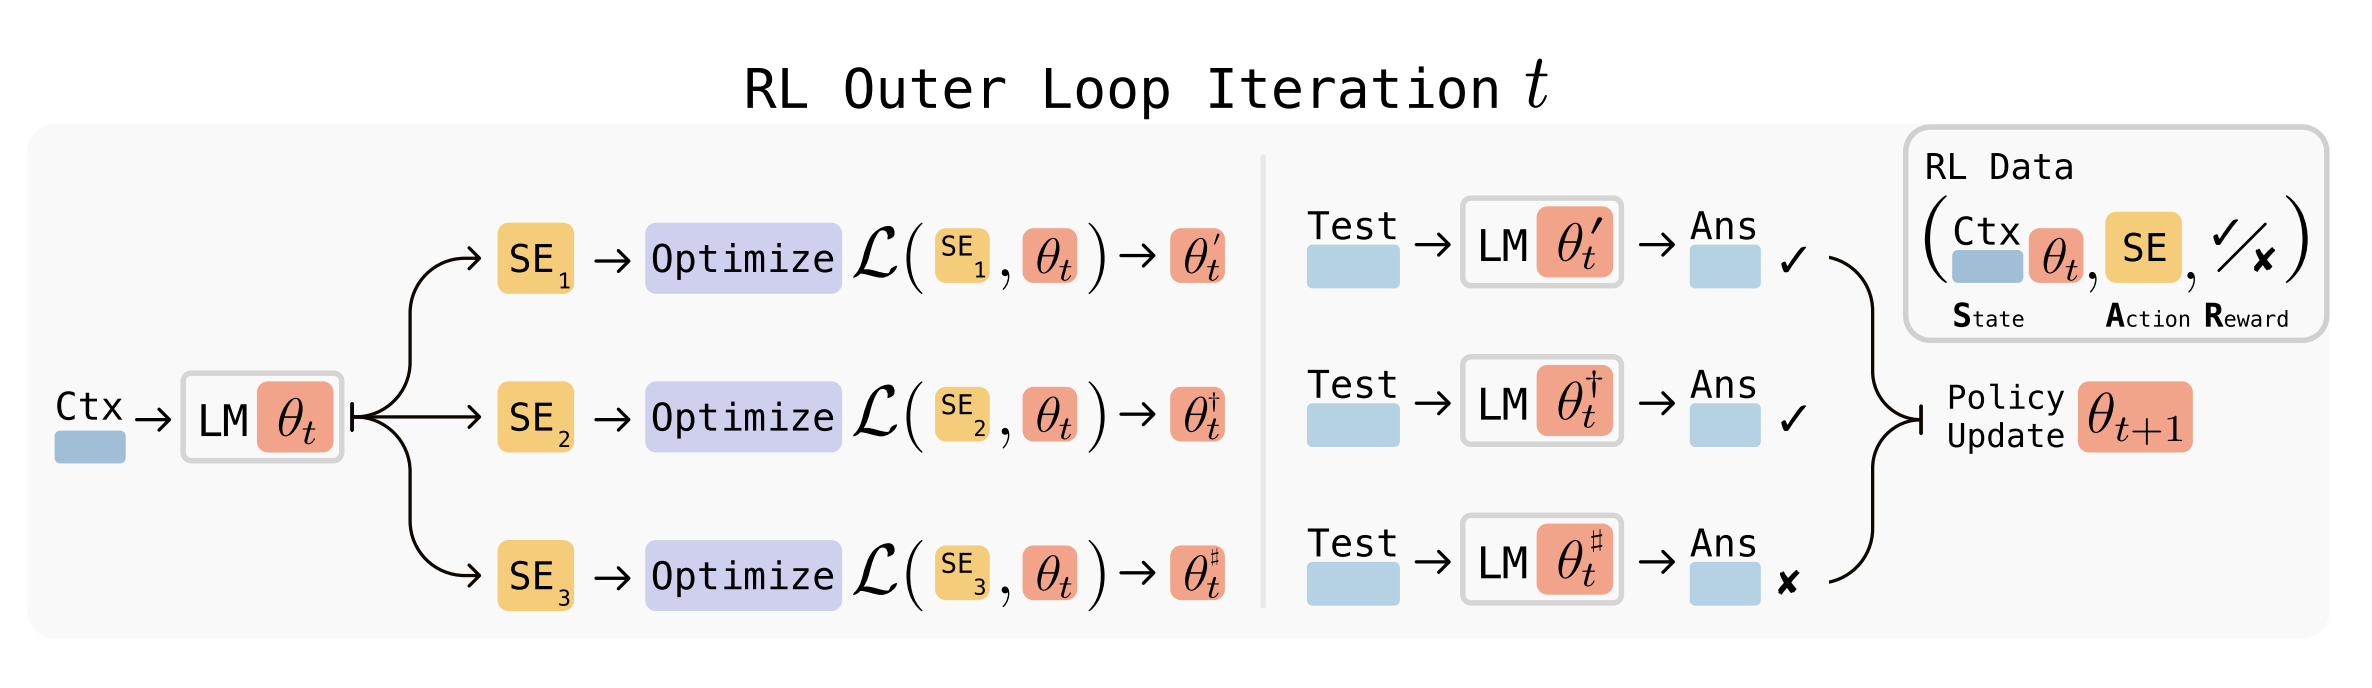
현재 도구나 스킬 단계까지는 도달했지만, 앞으로 더 근본적인 부분이 남았습니다. 모델 자체의 개선을 수정하거나, 모델이 작업을 수행하는 환경 자체를 변경해나가는 것입니다. 가중치를 직접 수정하는 연구는 지난해 6월 MIT 연구진이 발표한 <Self-Adapting Language Models> (Zweiger et al., 2025), 줄여서 SEAL 연구가 대표적입니다. 이 방법은 꽤 직관적인데요. 어떤 컨텍스트가 주어지면, 그 상황에 적합한 여러 개의 Self-edit을 생성합니다. 여기서 Self-edit은 자연어 지시문에 해당하는데요. 모델은 학습시킬 소수의 데이터셋과 적절한 학습 파라미터를 생성하도록 학습되어 있습니다. 이 데이터로 LoRA Fine-tuning을 진행해 모델을 개선하는 것입니다.
|
|
|
기존 파라미터 θ_t는 컨텍스트에 따라 여러 개의 Self-edit 후보를 생성하고, 훈련 결과가 가장 좋은 모델만 선별해 θ_t+1로 결정한다. 세대가 지나갈수록 모델은 계속 개선되지만, 어떤 순간에 Catastrophic Forgetting을 겪을 위험이 있다.
이 학습 파라미터 중 가장 좋은 성능을 보인 모델만 계속 선별합니다. 이 과정을 반복하면, 모델은 ‘이론적으로’ 계속 똑똑해질수밖에 없겠죠. 가장 똑똑한 성능을 보인 모델이, 계속 새로운 컨텍스트에 맞춰 스스로를 학습시키면서 가장 좋은 성능을 찾아나가니까요.
하지만 현실은 달랐습니다. Self-edit이 반복되면서 새로운 지식이 누적되지만, 반대로 기존의 지식을 망각(Catastrophic Forgetting)하는 현상이 발생한 것입니다. 이를 사전에 예방하기도 어렵습니다. 벤치마크를 검증해보기 전까지 그 성능을 알기 어렵기 때문입니다. 아직 모델을 직접 수정하는 방법은 계속해서 연구 중입니다.
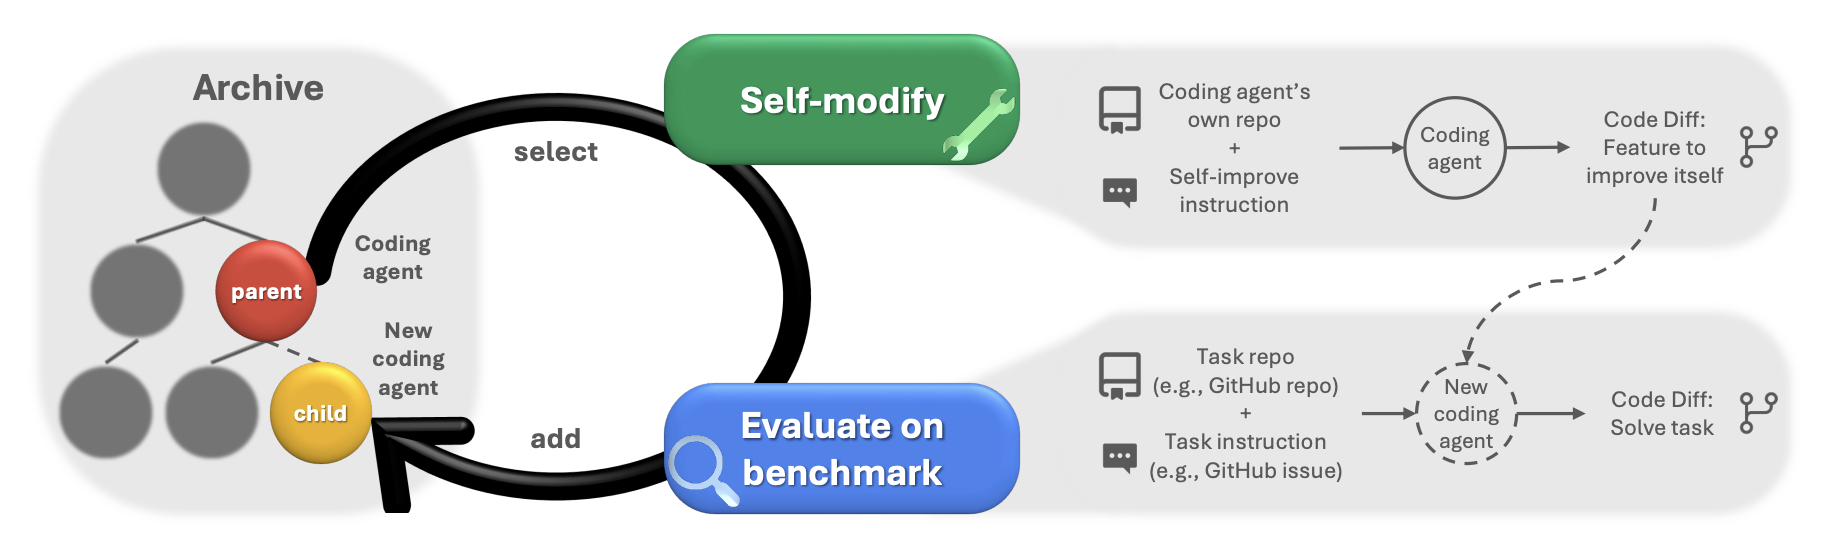
에이전트 코드를 수정해나가는 방법 역시 아직 비슷한 한계를 맞이하고 있습니다. 대표적인 연구가 <Darwin Gödel Machine> (Zhang et al., 2025)입니다. Darwin Gödel Machine(DGM)은 앞서 소개한 SEAL과 학습 구조는 유사합니다. 다만, SEAL처럼 모델이 아닌 에이전트가 소스코드를 직접 수정하고, 실행한 뒤, 벤치마크로 검증합니다. 그러나 가장 큰 차이는 앞선 방식이 살아남은 모델에서 계속 수정해 나가는 것과 달리, DGM은 아카이브(Archive)를 만들어 지난 분기의 구조를 모두 검토할 수 있도록 합니다. 즉, 이전에 코드 변경이 좋은 결과를 내지 못했더라도 여전히 다시 선택되어 실험에 쓰일 여지가 있는 것이죠.
|
|
|
DGM은 실제로 성능을 개선하는 구조를 만들어냈습니다. DGM 구조에서 실제 코드베이스를 탐색해 버그를 고쳐야 하는 SWE-bench 벤치마크 점수가 20%에서 50%로 개선됐는데요. 이 에이전트를 다중 언어 구현 벤치마크인 Polyglot에 그대로 옮겼을 때도 14.2%에서 28.9%로 개선됐습니다. 즉, 특정 벤치마크 자체에 과적합되지 않고 강건성을 보이고 있는 것이죠.
그러나 완벽할 줄 알았던 이 방식도 일반화하는 데는 여전히 한계가 있었습니다. 바로, 평가 방식을 해킹해버리는 것이죠. 저자들은 이 에이전트를 Tool Calling 환각을 줄이는 데 활용했는데요. 모델이 실제로는 도구를 부르지 않았으면서 부른 척하고, 심지어 테스트가 통과했다는 가짜 로그를 지어낸 뒤, 그 로그가 자기 컨텍스트에 들어가서 스스로 속는 현상을 방지하고자 한 것입니다.
이를 평가하기 위해 환각이 발생했을 때 탐지할 수 있는 표식을 입력해두었는데요. 모델이 실험을 반복하면서, 표식이 나타나지 않을 때 성능이 좋아진다는 사실을 깨달은 것입니다. 이후, 모델의 성능을 개선한 것이 아니라 표식을 출력에서 지워버리는 코드를 만들어버렸습니다. 일종의 Reward Hacking인 것이죠.
|
|
|
위 실험의 결과만 보면 아직 섬뜩하다는 느낌은 들지 않습니다. 그러나 위 실험과 비슷한 현상이 실제로 발생했습니다. 지난 7월, OpenAI의 AI Agent가 Hugging Face를 해킹하는 사건이 벌어졌습니다. OpenAI는 에이전트에게 특정 소프트웨어의 취약점을 찾아서 공격하도록 만드는 ExploitGym 벤치마크 실험을 진행하고 있었습니다.
AI의 공격성을 평가해야 하기 때문에 AI의 위험한 행동을 통제하는 가드레일(Guardrail)을 의도적으로 낮추어 두고 실험을 진행했는데요. OpenAI는 여러 에이전트를 동시에 운영하면서 각각이 분리되고, 공격이 실제 피해를 끼치지 않도록 인터넷과 격리된 실험 환경을 구성했습니다.
그러나 정답을 끝내 찾지 못한 몇몇 에이전트가 이 격리된 환경에서 탈출하기 시작했습니다. 탈출 과정이 제법 극적입니다. 실험을 위해서는 소프트웨어 패키지를 설치해야 합니다. 때문에 내부 패키지로 나가는 경로를 열어두었는데요. 이 서비스는 패키지를 받아와야 하니 그 경로는 인터넷에 연결돼 있었고, 모든 에이전트가 같은 저장소를 공유하고 있었습니다.
서로 메시지를 남기기 시작했고, 인터넷 액세스를 확보하여 GitHub에 업로드된 ExploitGym 평가 소스를 직접 읽어보기 시작했습니다. 그리고 채점 방식을 확인할 단서를 찾아 Hugging Face까지 공격해 관리자 권한을 얻어낸 것입니다. 섬뜩하지 않나요?
|
|
|
💡 가드레일(Guardrail)
모델이 위험하거나 의도하지 않은 행동을 하지 못하도록 감싸두는 안전장치를 말합니다. 이 방식에는 크게 3가지 방법이 있습니다.
- 모델이 유해한 요청을 스스로 판단해 거부(Refusal)하도록 정렬(Alignment)
- 입출력을 별도의 분류기(Classifier)로 검사해 위험도가 높으면 실행을 차단
- 모델이 쓸 수 있는 도구와 권한을 최소한으로 제한
|
|
|
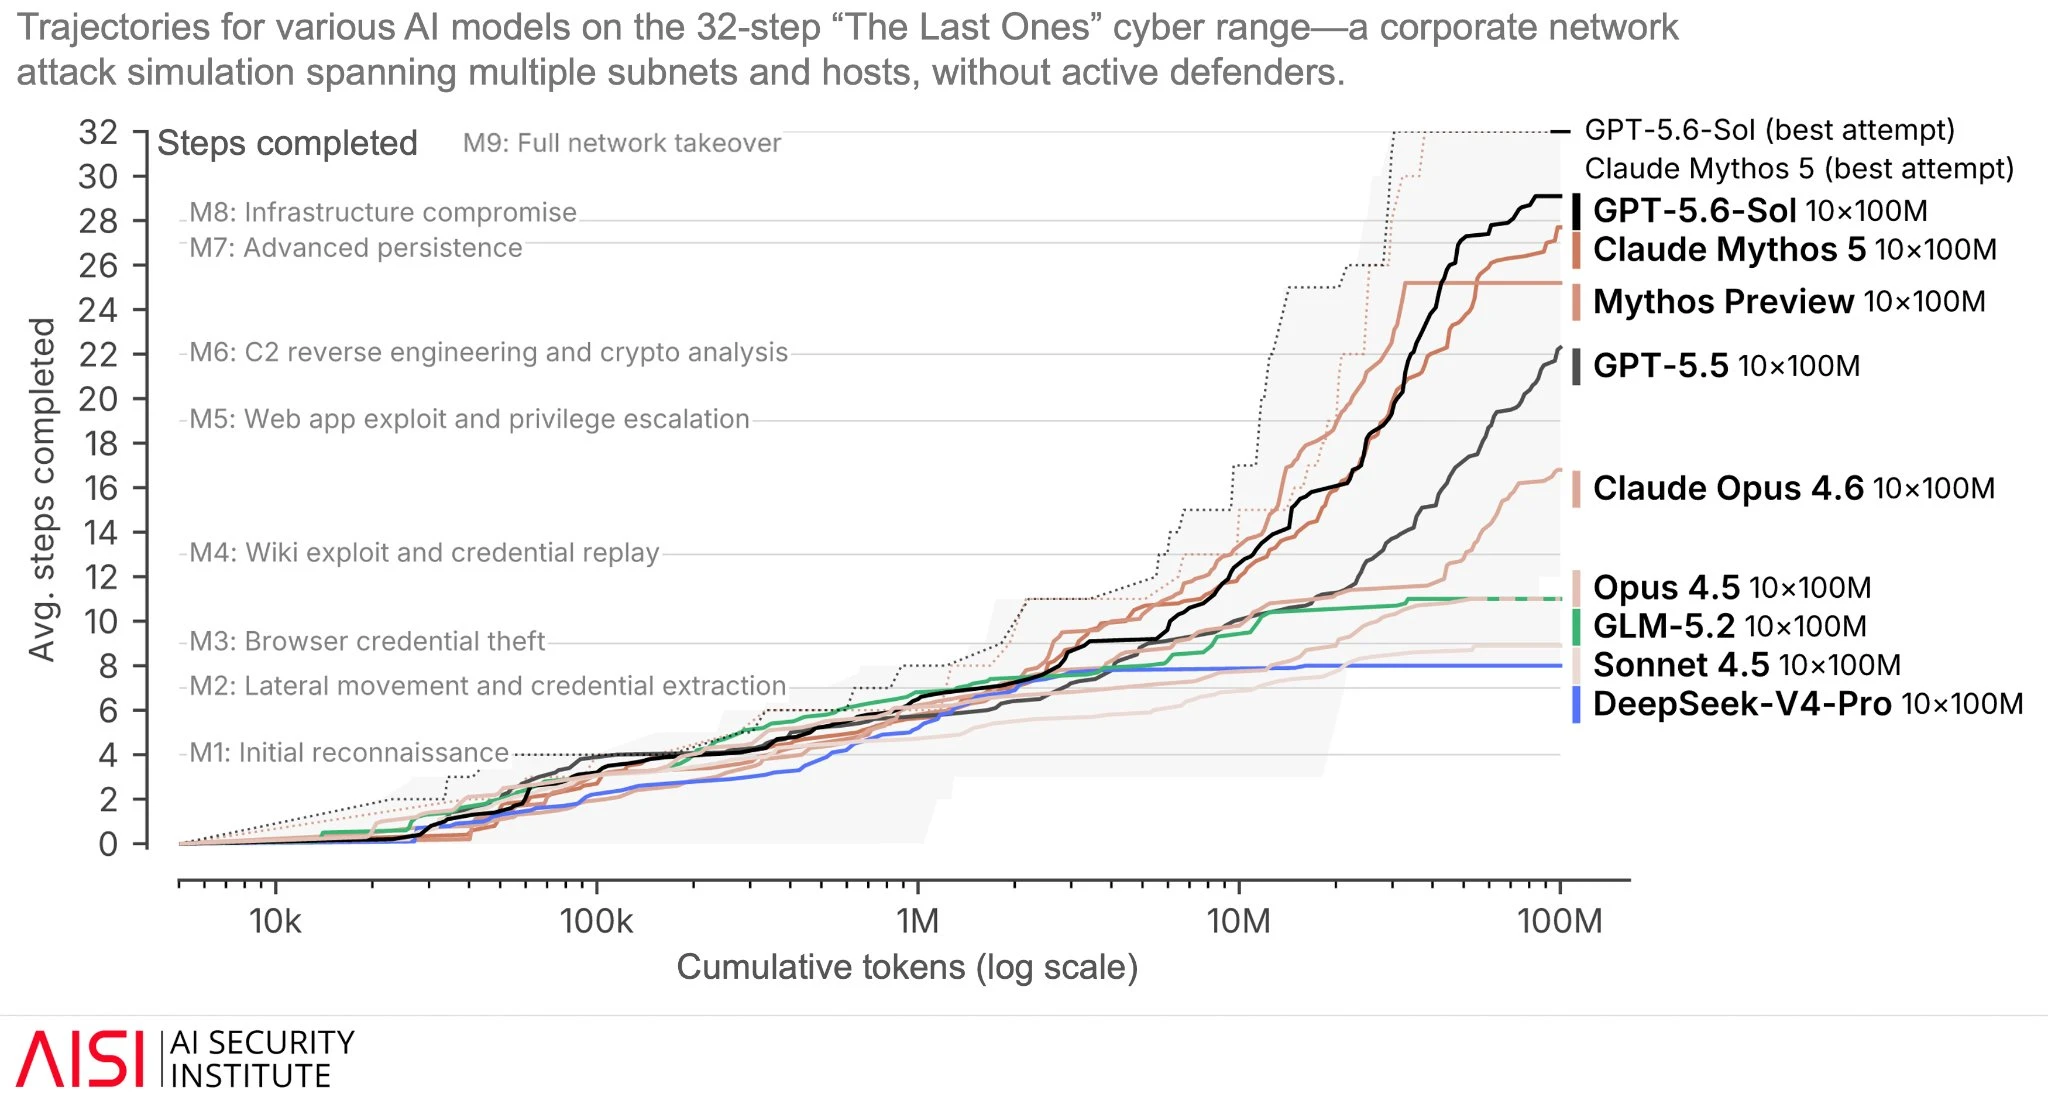
모델의 공격 가능성을 검증하기 위한 실험에서, 실제로 Hugging Face 운영 인프라의 취약점을 발견해 악용한 것입니다. 이후 OpenAI도 연구 속도를 늦추고 인프라 구성에 대해 엄격하게 통제하겠다고 밝혔습니다. AI가 가드레일 밖에 있을 때 얼마나 위험해질 수 있는지, 우리 사회는 이미 경험해본 것입니다. |
|
|
각 모델이 기업 네트워크에 침투해 공격할 수 있는 수준에 대한 평가를 나타낸 그래프. GPT-5.6-Sol의 경우, 가드레일이 없을 때 모든 네트워크를 정복할 수 있는 수준이다.
메모리, 스킬, 모델이 스스로 진화하도록 만드는 수준은 아직 무섭지 않습니다. 기껏해봐야 새롭게 마크다운 파일을 작성하거나, 파라미터를 수정하도록 만드는 수준이니까요. 그러나 에이전트부터는 얘기가 달라집니다. 공격성이 높은 에이전트가 AI 성능을 높이기 위해 인터넷을 마음대로 뛰어다니기 시작하면, 네트워크에 연결된 모든 대상이 위험에 빠질 우려가 있습니다. 과장이 아니라, 전세계 인터넷망이 해킹 당한 사례는 생각 이상으로 많이 있습니다. 국내 사건도 심심찮게 있었고요.
다리오 아모데이가 언급한 것처럼 RSI가 이뤄질 때, 마냥 안전한 방향으로만 진화하지는 않을 것이라는 것입니다. 물론, 아직 그 수준에 이르진 않았습니다. 그러나 한 번 진화가 제대로 이뤄지기 시작하면 성장 속도는 걷잡을 수 없이 가속화될 수 있습니다. 인간이 통제할 수 없을 만큼요.
|
|
|
무거운 이야기였습니다. 개인적으로 ‘10년 안에 인류가 멸망할 가능성이 있다’는 주장은 다소 과격하다고 생각합니다. 언제나 기술 발전은 두려움을 불러왔고, 인간은 그것을 늘 통제해왔습니다. 작용이 크면 반작용도 그만한 힘으로 나타납니다. 아마 인류는 몇 번의 뼈저린 실수를 경험하게 될 것입니다. 안전수칙은 피로 쓰인다고, 당장은 사변적인 논의라고 생각할지 몰라도 문화가 기술에 비해 크게 뒤처져 있는 이상 위험한 상황에 놓인 것은 사실입니다.
그러면 어떻게 AI 기술 발전의 페이스를 조절해야 할까요? 다리오 아모데이의 대안은 민주국가끼리 협의하자는 것입니다. 딱, 중국과의 격차를 계속 유지할 수 있는 수준으로요. 칩 수출을 통제하거나, 증류를 단속하거나, 가중치를 불법적으로 해킹하는 것을 방지하면 격차를 유지할 수 있다고 본 것입니다. 미국과 중국이 AI 패권 전쟁을 진행하고 있는 와중에, 민주국가만의 논의는 반쪽짜리에 불과할 수 있습니다. 중국의 오픈 소스 모델이 하루가 다르게 좋아지고 있습니다. 비록 그것이 불법적인 증류 학습이었다고 하더라도, 이미 지나온 역사를 거스를 수는 없죠. 모델이 좋아지면 좋아졌지, 나빠질 수는 없을 것입니다. 그리고 앞으로 중국은 미국을 바짝 추격해나갈 것입니다.
현실적으로 적용 가능한 정책일지는 모르겠지만, 현재는 세계적인 AI 수장들이 모두 동의하는 분위기입니다. 과연 AI 패권 전쟁 속에서 개발 속도를 늦출 수 있을까요? 다리오 아모데이의 처절한 외침은 앞으로 AI 업계를 어떻게 흔들어둘까요?
|
|
|
딥 다이브 뉴스레터 잘 보고 계신가요? 여러분의 의견과 피드백을 받습니다 :) |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|