AI가 아직 포켓몬 배틀을 어려워 하는 이유를 설명합니다. #170 위클리 딥 다이브 | 2026년 11월 18일
에디터 배니 |
|
|
💡 이번주 뉴스레터에는 이런 내용을 담았어요!
- 포켓몬 팀 빌딩이 복잡한 이유를 요약했습니다.
- 포켓몬 대전과 관련된 경제학 개념을 정리했습니다.
- 포켓몬 배틀의 연구 사례를 소개했습니다.
|
|
|
안녕하세요, 에디터 배니입니다.
AI와 관련된 세간의 이슈가 뜨겁습니다. AI를 활용해 국가 공인 시험에서 합격하는 부정 사례가 발생하면서, 시험의 공정함을 해친다는 것이죠. 이제 AI만 있으면 무엇이든 다 할 수 있을 것만 같습니다. 설령 아직까지 완전히 대체할 수 있는 수준은 아니라고 하더라도 사회 구조에 큰 지각 변동이 있을 것은 분명해 보입니다.
하지만, AI에게도 여전히 어려운 것이 많이 남아 있습니다. 그중 하나가 바로, 포켓몬 배틀입니다. AI가 바둑은 이미 제패한 지 오래고, 스타크래프트(AlphaStar)나 Dota 2 같은 실시간 협동 게임뿐만 아니라, 사람과 함께하는 심리 게임도 모두 이겨 버리는 AI인데 남녀노소 누구나 쉽게 즐길 수 있는 포켓몬 배틀을 잘하지 못한다니 아이러니합니다.
심지어는 세계적으로 권위 있는 학술대회 NeurIPS 2025에서 포켓몬 에이전트 관련 대회가 개최됐는데요. 지난 대회의 성과를 바탕으로 오는 12월 열리는 NeurIPS 2026에서 PokéAgent 연구가 발표될 예정입니다. 어려운 문제도 척척 푸는 그 똑똑한 AI가 포켓몬 배틀을 어려워하는 이유가 무엇일까요? 이번 주 뉴스레터에서는 포켓몬 배틀의 난제를 지적한 <The PokéAgent Challenge>를 소개합니다. |
|
|
어렸을 때 포켓몬 게임을 해보신 분들이라면 포켓몬 배틀이 어떻게 이뤄지는지 어느 정도 알고 계실 것입니다. 하지만 여기서 말하는 포켓몬 배틀은 조금 다릅니다. 스토리 모드를 진행하면서 포켓몬을 잡거나 NPC와 배틀하는 것이 아니라 실제 사람과 PvP 배틀하는 것을 의미합니다.
|
|
|
놀랍게도 포켓몬에도 배틀 세계 대회가 존재합니다. 기본적으로 6마리의 포켓몬으로 파티를 꾸려 엔트리를 등록하고, 싱글 배틀이라면 총 3마리를 선발해 필드에 1마리씩, 더블 배틀은 총 4마리를 선발하여 2마리씩 내보냅니다. 이러한 포켓몬 배틀 게임의 전략은 크게 1) 팀 빌딩(Team Building)과 2) 대전(Battling) 두 가지로 구분할 수 있습니다.
지난해 NeurIPS 2025에서는 <Pokémon as an AI Problem> 주제의 발표가 있었는데요. 강연자로 나선 Aaron Traylor는 포켓몬 월드 챔피언십에서 최고 성적 8강에 오른 선수입니다. 그냥 게임을 잘하는 사람이 아니라, AI 연구자이기도 합니다. 그는 포켓몬 배틀의 두 가지 전략 요소가 AI가 포켓몬 배틀을 플레이하는 데 어려운 요소라고 설명합니다.
우선, 팀 빌딩입니다. 이미 1,000가지가 넘는 포켓몬이 있고, 각 포켓몬이 가질 수 있는 기술의 수도 900가지가 넘습니다. 그중에서 배틀에는 단 6마리를 선택해야 하고, 각 포켓몬마다 4가지의 기술을 선택해야 합니다. 거기에 배틀 기믹, 특성, 도구 등의 경우의 수까지 계산한다면 무려 10^218개의 경우의 수가 존재합니다. 참고로 체스의 경우의 수를 약 10^50 정도로 추정합니다. 얼마나 많은 경우의 수를 고려해야 하는지 감이 잡히지 않습니다. |
|
|
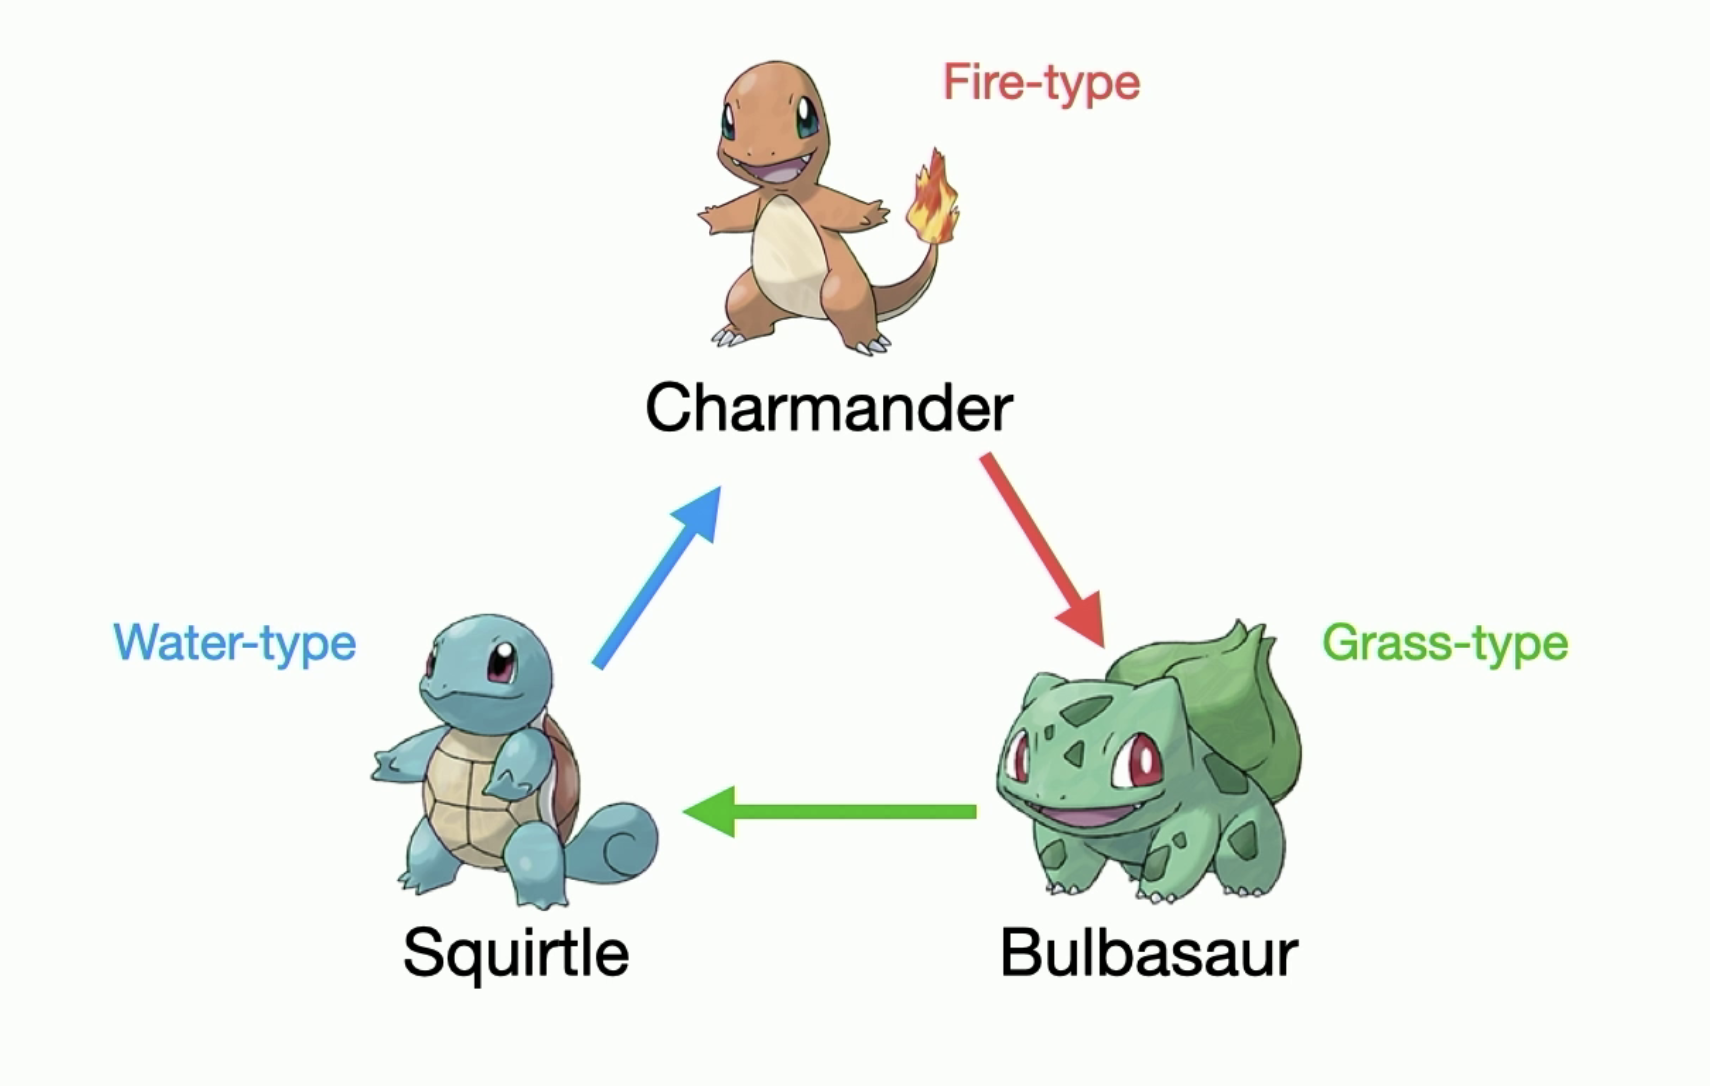
포켓몬의 타입 상성 관계. 화살표는 공격하는 쪽에서 약점을 가진 쪽으로 향하며,
상성이 유리하면 기술이 2배의 데미지를 준다.
하지만 일반적으로 강한 포켓몬들이 있죠. 소위 전설의 포켓몬 같이 강한 포켓몬들로만 구성한다면 이길 수 있지 않을까요? 그렇지 않습니다. 내가 강한 포켓몬을 파티에 포함할 수 있다는 것은, 상대도 가능하다는 의미가 됩니다. 결국 상대보다 강해야 이길 수 있는 것이기에, 강한 포켓몬의 허를 찌를 수 있는 포켓몬을 포함시킵니다. 포켓몬에는 불꽃, 물, 풀 등 다양한 타입 상성이 존재하기 때문에 항상 모두에게 강한 포켓몬은 존재하지 않죠.
만약 어떤 대회에서 파이리가 높은 승률을 보였다면, 자연스럽게 다음 대회에서는 꼬부기 채택을 고려하게 됩니다. 그래서 꼬부기가 좋은 승률을 보이면 다음 대회에서는 꼬부기를 대비해 이상해씨를 채택하겠죠. 이렇게 계속해서 꼬리에 꼬리를 무는 구조가 됩니다. 이를 메타 게임(Meta-game)이라고 합니다.
|
|
|
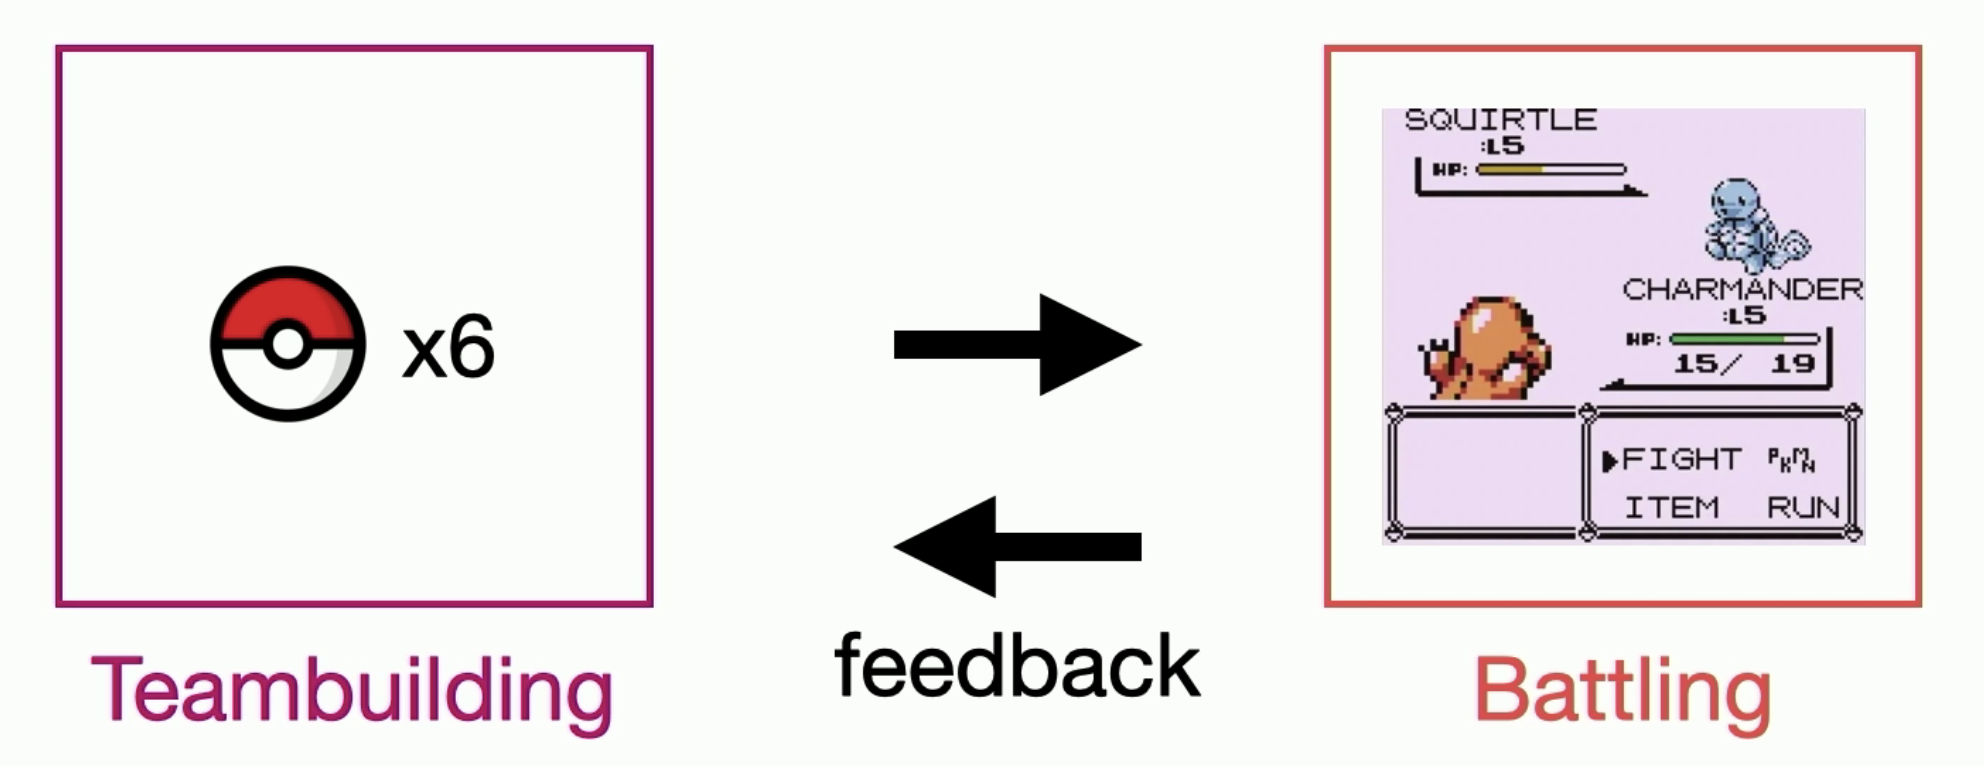
팀 빌딩과 대전의 관계. 서로 피드백이 의존적이며, 좋은 팀 빌딩을 검증하기 위해서는 반드시 배틀을 거쳐야 한다.
출처: Aaron Traylor, <Pokémon as an AI Problem> (NeurIPS 2025 PokéAgent Workshop, PokéAgent Workshop Talk)
문제는 한 팀만 이기면 되는 것이 아닙니다. 실제 대회에서는 한 번 팀을 등록하면 대회가 끝날 때까지 바꿀 수 없는데요. 즉, 한 팀으로 대회에서 만날 상대 팀 분포 전체에 대비해야 한다는 뜻입니다. 팀 빌딩을 잘하기 위해서는 팀에 대한 평가가 필요한데요. 이 팀이 좋은 팀인지 판단하기 위해서는 실제로 배틀을 해봐야 합니다. Aaron Traylor는 이를 2단계 최적화(2-step Optimization)라고 부릅니다.
이런 환경 자체가 AI가 학습하기 좋은 상황이 아닙니다. 수많은 경우의 수 중 많아 봐야 수백 번의 대전에서 얻은 피드백으로 팀을 개선해야 합니다. 만약 그것이 팀 빌딩의 문제가 아니라, 팀을 운용하는 문제라면 더더욱 상황은 복잡해집니다. 실제로 선수들의 경기에서도 다양한 실전 경험을 기반으로, 약점을 서로 상쇄할 수 있는 조합의 기본적인 팀 구성과 더불어 매번 그 시기의 트렌드(소위 ‘메타’)를 읽으며 팀을 수정하고는 하죠. |
|
|
팀을 다 구성했다면 이제 실제 대전으로 넘어가야 합니다. 팀만 잘 구성한다고 해서 대전에서 이기는 게 아닙니다. 실제로 매 턴마다 최선의 선택을 해야 하는데, 여기에 몇 가지 함정이 있습니다.
두 플레이어는 모두 상대 포켓몬의 정보를 제대로 알지 못한 채 기술을 선택해야 합니다. 특성과 도구, 그리고 (진심으로 게임을 즐기시는 분들이라면 아시겠지만) 노력치, 성격 등까지도 모두 고려해야 합니다. 하지만 이런 상황에서도 결정을 내려야 다음 결과가 관찰이 가능합니다.
이런 상황을 경제학 용어로 불완전한 정보(Imperfect Information)라고 합니다. 마치 중고시장 같은 것이죠. 중고 물품을 보유한 판매자는 결함 등의 정보를 가린 채 판매하고, 구매자는 결함이 있다고 가정하고 가격을 낮추려고 합니다. 실제로 구매를 해봐야 결함 여부를 알 수 있기 때문에 불확실성을 안고 거래에 임해야 합니다. 포켓몬 대전에서도 마찬가지죠. |
|
|
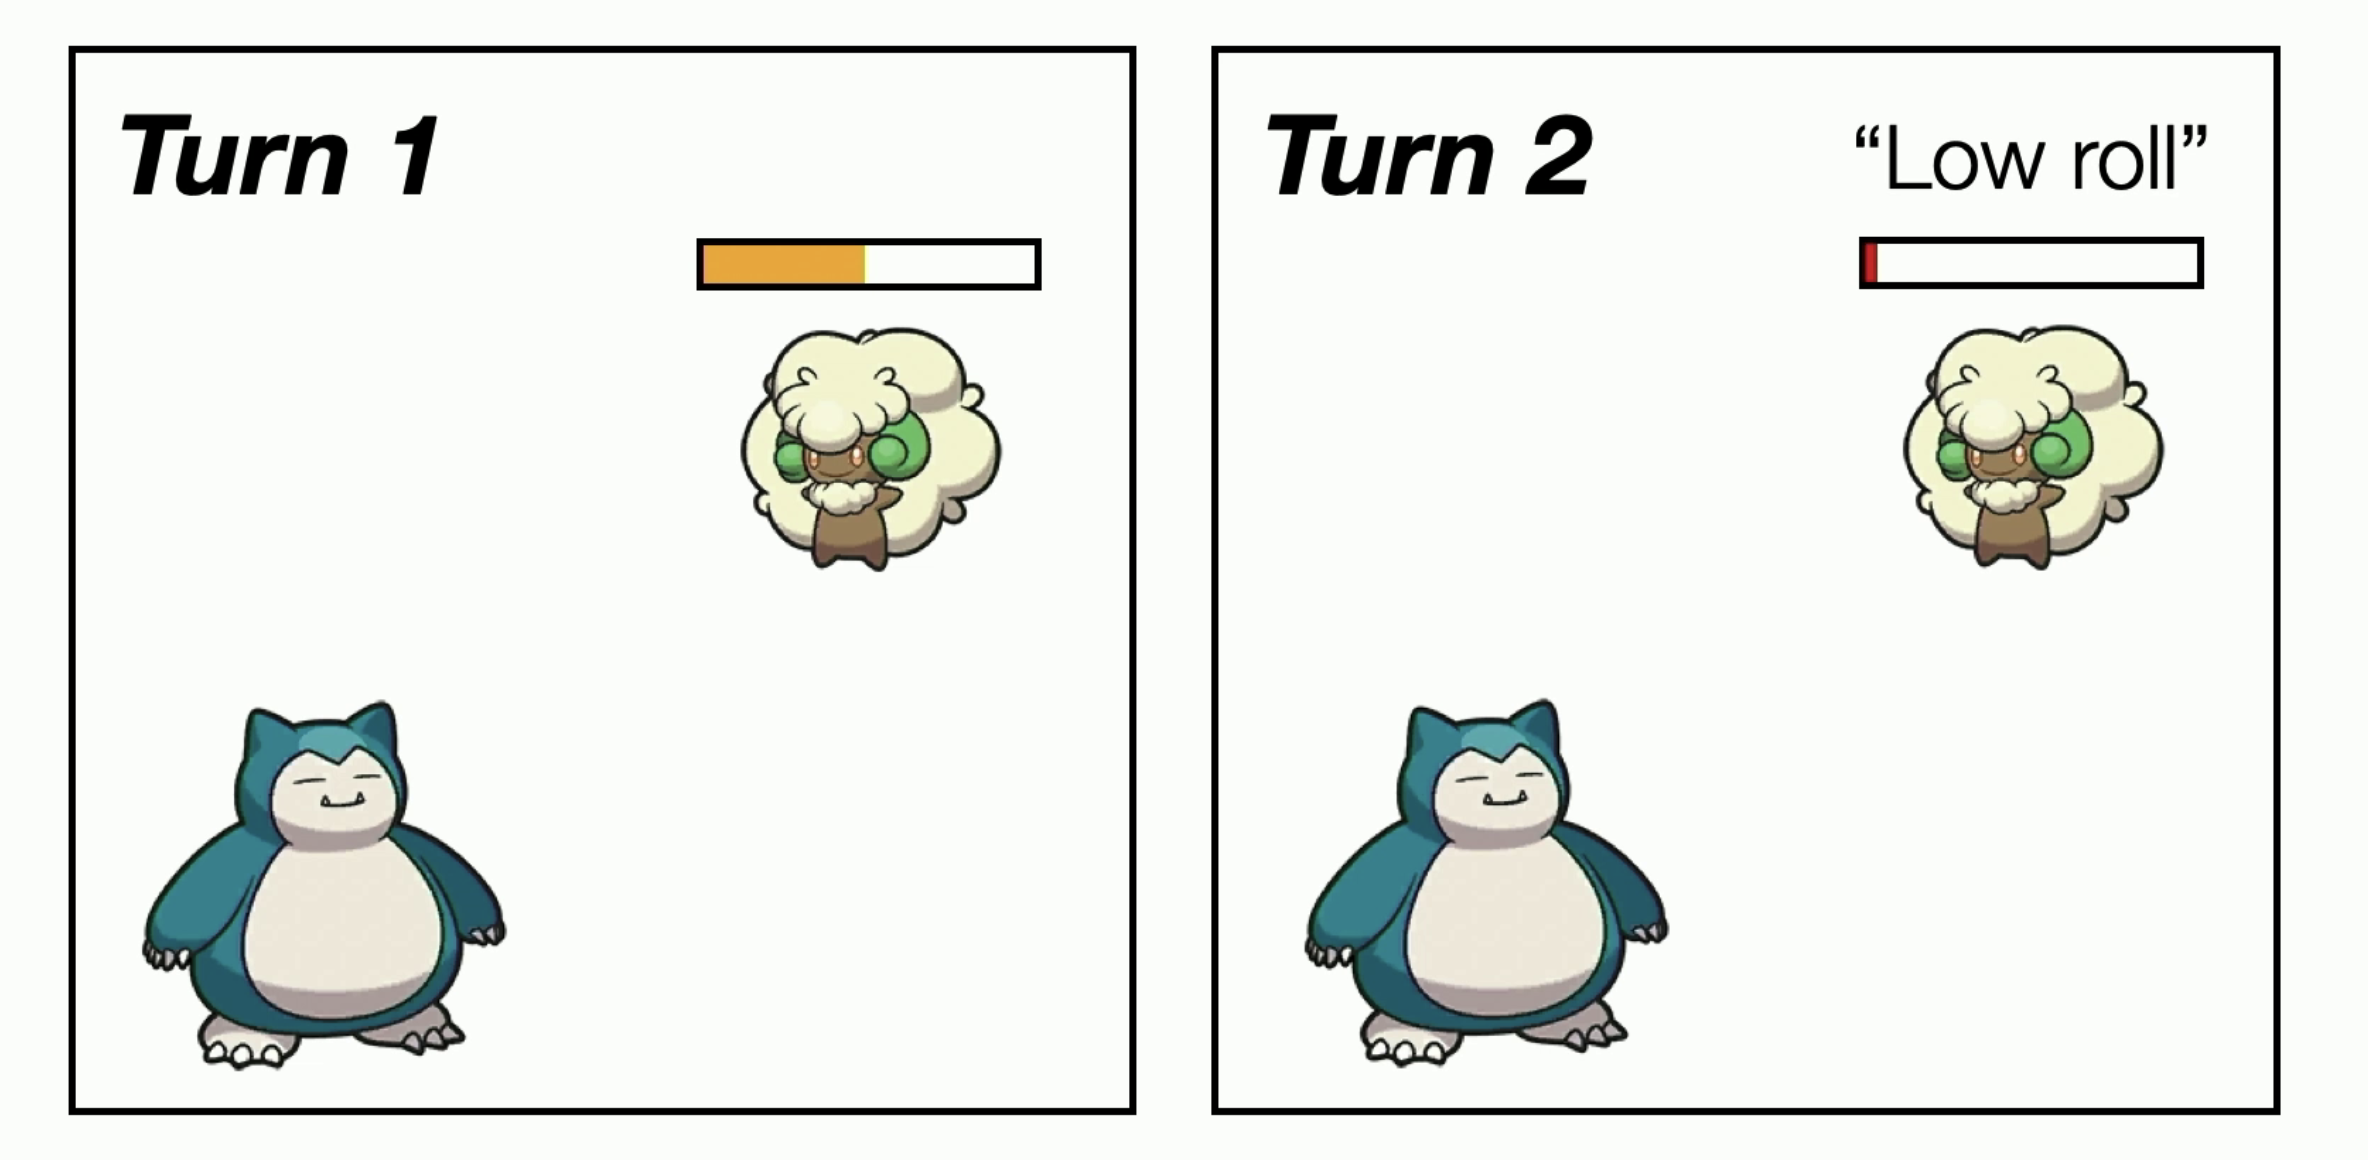
대미지 난수 때문에 생기는 저난수(Low Roll)가 발생하면, 쓰러질 것으로 기대한 포켓몬이 살아남기도 한다.
그리고 애초에 기술의 위력과 명중률부터 불확실성을 가지고 있습니다. 포켓몬의 기술이 같은 상대에게 항상 같은 피해를 입히는 것이 아닙니다. 우리나라에서는 주로 ‘난수’라고 부르는데 실제로는 약간의 랜덤성이 부여되어 있습니다. 이 역시 학습과 평가를 어렵게 하는 요소로 작용합니다. 어떤 때는 이기기도 하지만, 반대로 어떤 때는 아슬아슬하게 지기도 하죠. 같은 상대를 만나 같은 행동을 여러 번 반복해야 실제로 어느 쪽이 강한지 알 수 있습니다.
결국 이런 결정들이 매 턴 누적되어 최종적인 승패가 갈리게 됩니다. 턴제 게임이 모두 그러하듯 승패를 결정한 결정적인 요소를 찾아 보상을 매기기가 어려워집니다. 이는 강화학습에서는 신용 할당(Credit Assignment) 문제에 해당합니다. 단계별로 추론하는 Reasoning Model이나, 여러 단계에 걸쳐 판단하는 에이전트에서도 나타나는 문제죠.
가장 어려운 점은 내 결정과 상대의 결정이 동시에 이뤄진다는 점입니다. 체스나 바둑의 경우에는 매 턴 번갈아가며 두기 때문에 상대의 수를 보며 대응이 가능한데요. 포켓몬에서는 상대의 행동을 고민하며 예측해야 합니다. 내가 유리한 상황이라고 해도, 상대가 그것을 인지하고 있다면 다시 주도권을 갖기 위해 교체할 수도 있습니다. 결국 이 과정이 계속 순환하게 되며 선뜻 최선의 선택을 결정하기 어려워집니다.
게임 이론에서는 이 문제의 해법으로 혼합 전략(Mixed Strategy)을 제시합니다. 내 행동을 정해진 확률로 섞어 결국에 상대도 나도 서로의 선택을 읽기 어렵도록 만드는 균형점을 찾는 것이죠. 어느 쪽도 전략을 바꿔서 더 이득을 볼 수 없는 상태를 내쉬 균형(Nash Equilibrium)이라고 합니다. 실제 대회에서도 이러한 심리전 양상이 자주 보이고, 모든 요소를 종합적으로 고려하여 한 턴에 45초, 전체 7분 이내에 결정해야 합니다.
이런 점을 고려하면 초중반에 최적의 수를 계산하는 것은 불가능에 가깝습니다. 포켓몬 대회에 참여하는 선수들은 이를 체스, 포커, 가위바위보가 합쳐진 경기로 비유하기도 합니다. 지금의 움직임으로 미래를 예측하고, 서로의 정보가 불완전하며, 동시 선택으로 운명이 결정되기 때문입니다.
|
|
|
그렇다면 이렇게 복잡도가 높은 포켓몬 배틀을 연구자들은 어떤 식으로 해결할까요? 현재 연구 흐름은 크게 두 분야로 나뉩니다. 강화학습 기반의 에이전트와 Frontier LLM을 활용한 판단입니다. |
|
|
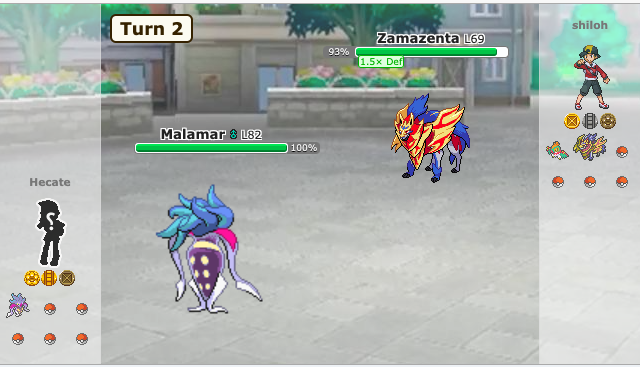
비공식 포켓몬 배틀 시뮬레이터 Pokémon Showdown에서 싱글 배틀을 하고 있는 장면
지난해 열린 PokéAgent Challenge는 강화학습 계열의 대표 프로젝트인 Metamon 팀과, 언어 모델 계열의 대표 프로젝트인 PokéChamp 팀이 함께 주최했는데요. 같은 규칙 위에서 두 방식을 나란히 겨뤄 볼 수 있도록 판을 깔았다는 점이 의미가 큽니다.
게임 AI에서 자주 사용하는 방법론이 강화학습입니다. 강화학습은 매번 주어진 상태를 관찰하며 제한된 환경 내에서 행동하고, 보상을 얻는 방식이기 때문에 규칙이 정해진 게임에 적용하기 유리하다고 알려져 있습니다. 바둑의 AlphaGod와 스타크래프트의 AlphaStar도 모두 강화학습 계열입니다.
|
|
|
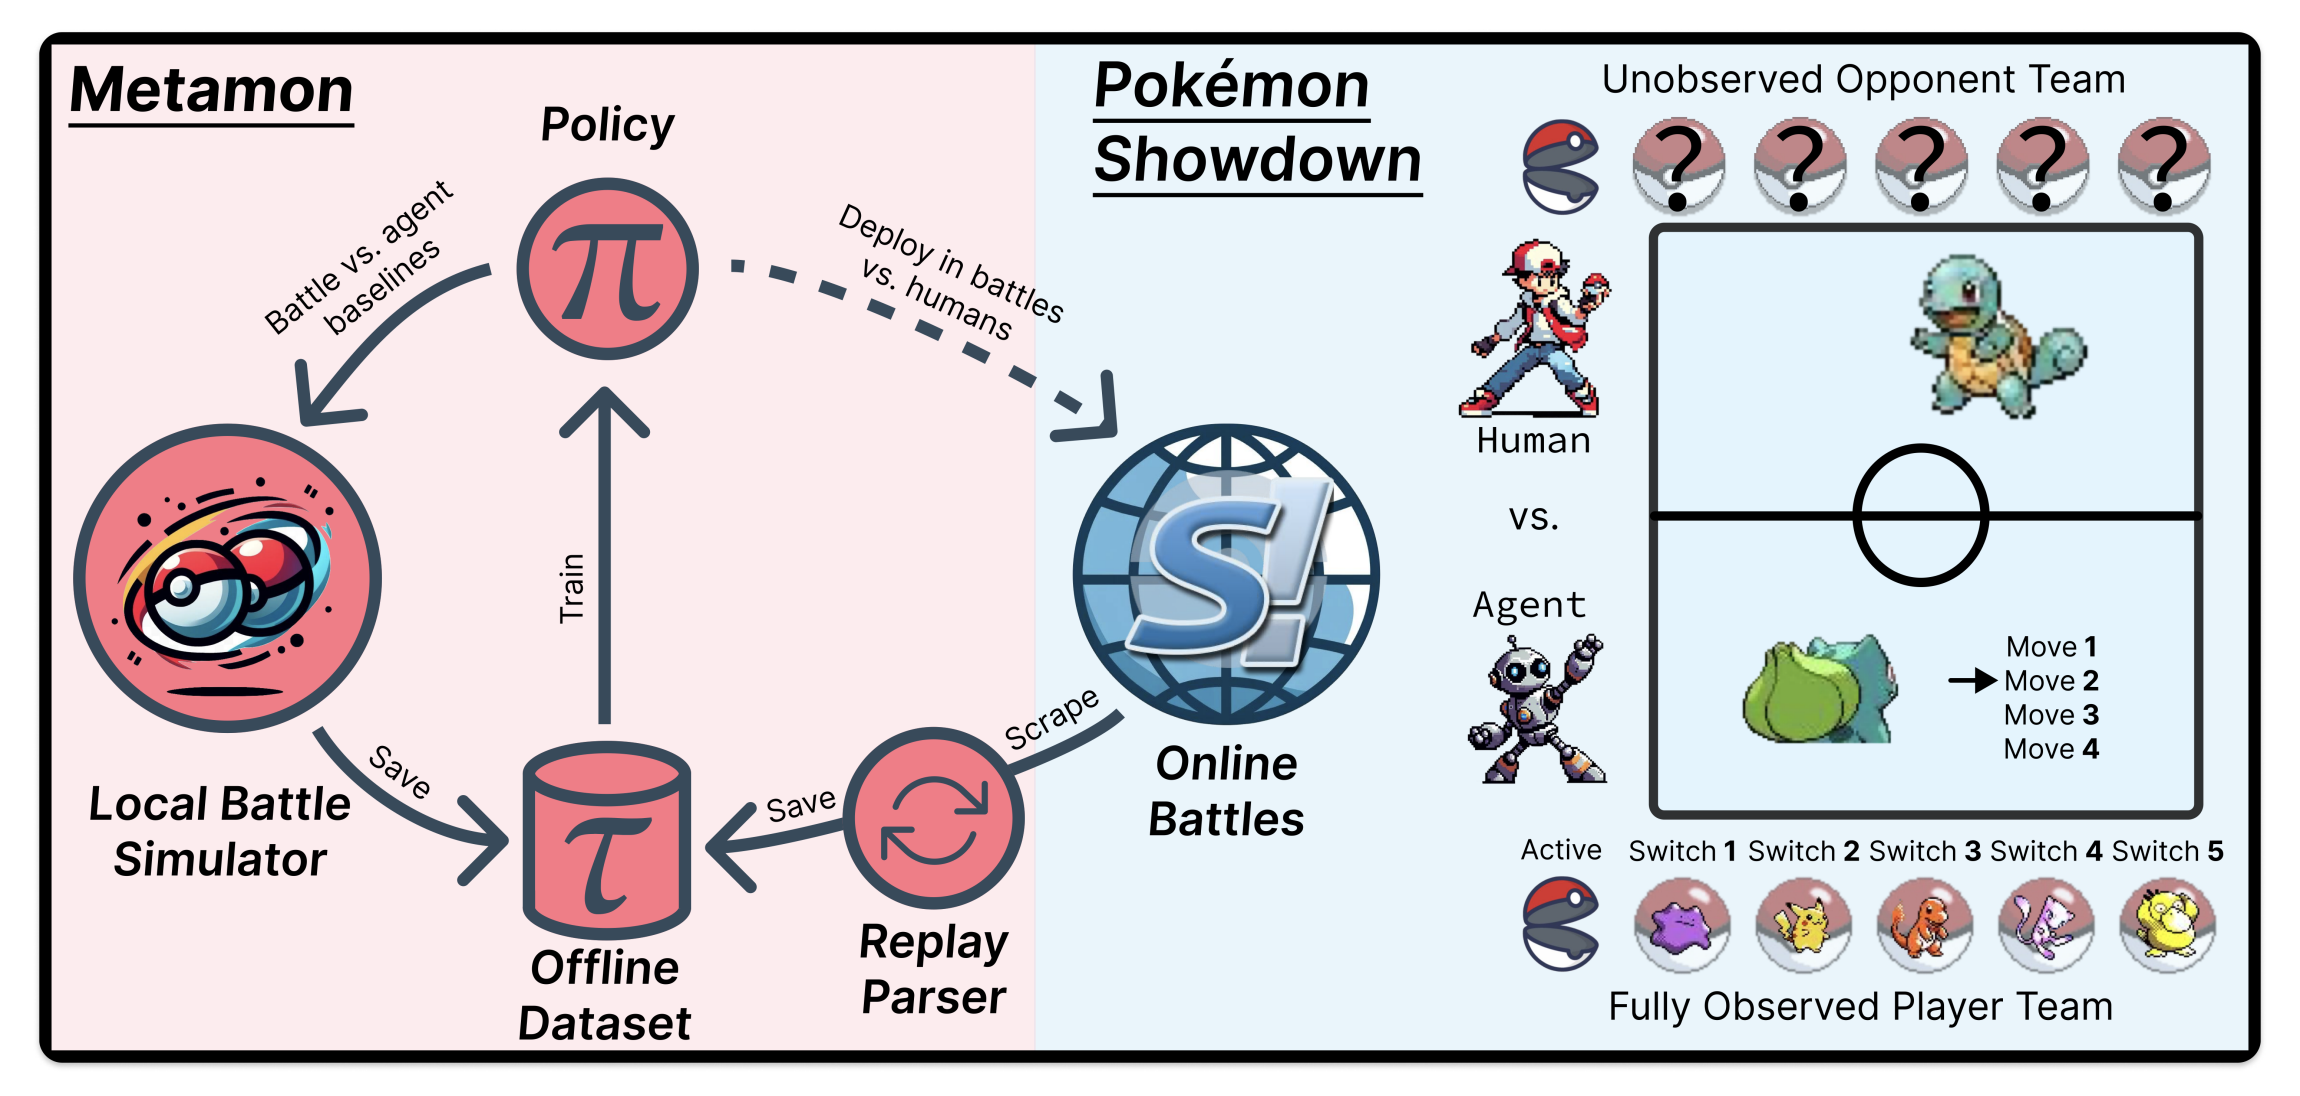
Metamon의 학습 및 평가 파이프라인. 오프라인으로 학습하고, 온라인에서 실전 배틀을 한다.
출처: Human-Level Competitive Pokémon via Scalable Offline Reinforcement Learning with Transformers (Grigsby et al., 2025)
온라인 포켓몬 대전 플랫폼인 Pokémon Showdown에는 10년 치 대전 기록이 쌓여 있는데요. 텍사스 오스틴 대학교의 연구진이 개발한 Metamon은 이 기록으로 오프라인 강화학습(Offline RL)을 합니다. 쉽게 말하면, 직접 게임을 하며 시행착오를 겪는 대신 이미 남겨진 기록만 보고 배우는 방식입니다. AlphaGo와 같이 바둑 기사와 직접 대국을 두지 않고 기보만 수만 장 복기하며 실력을 키우는 것과 비슷합니다.
그러나 기록만 가지고는 사람 수준을 넘어서기 어렵습니다. 그래서 Metamon은 학습한 에이전트끼리 서로 싸우게 하는 셀프플레이(Self-Play)로 데이터를 계속 늘렸습니다. 이렇게 모은 대전 기록이 2,000만 건을 넘었고, 이 과정에서 작은 순환 신경망(RNN)부터 트랜스포머 계열 모델까지 실력대가 다른 에이전트 30개가 만들어졌습니다. 가장 좋은 성능을 보유했던 에이전트 Kakuna는 승률 약 70% 수준이었습니다.
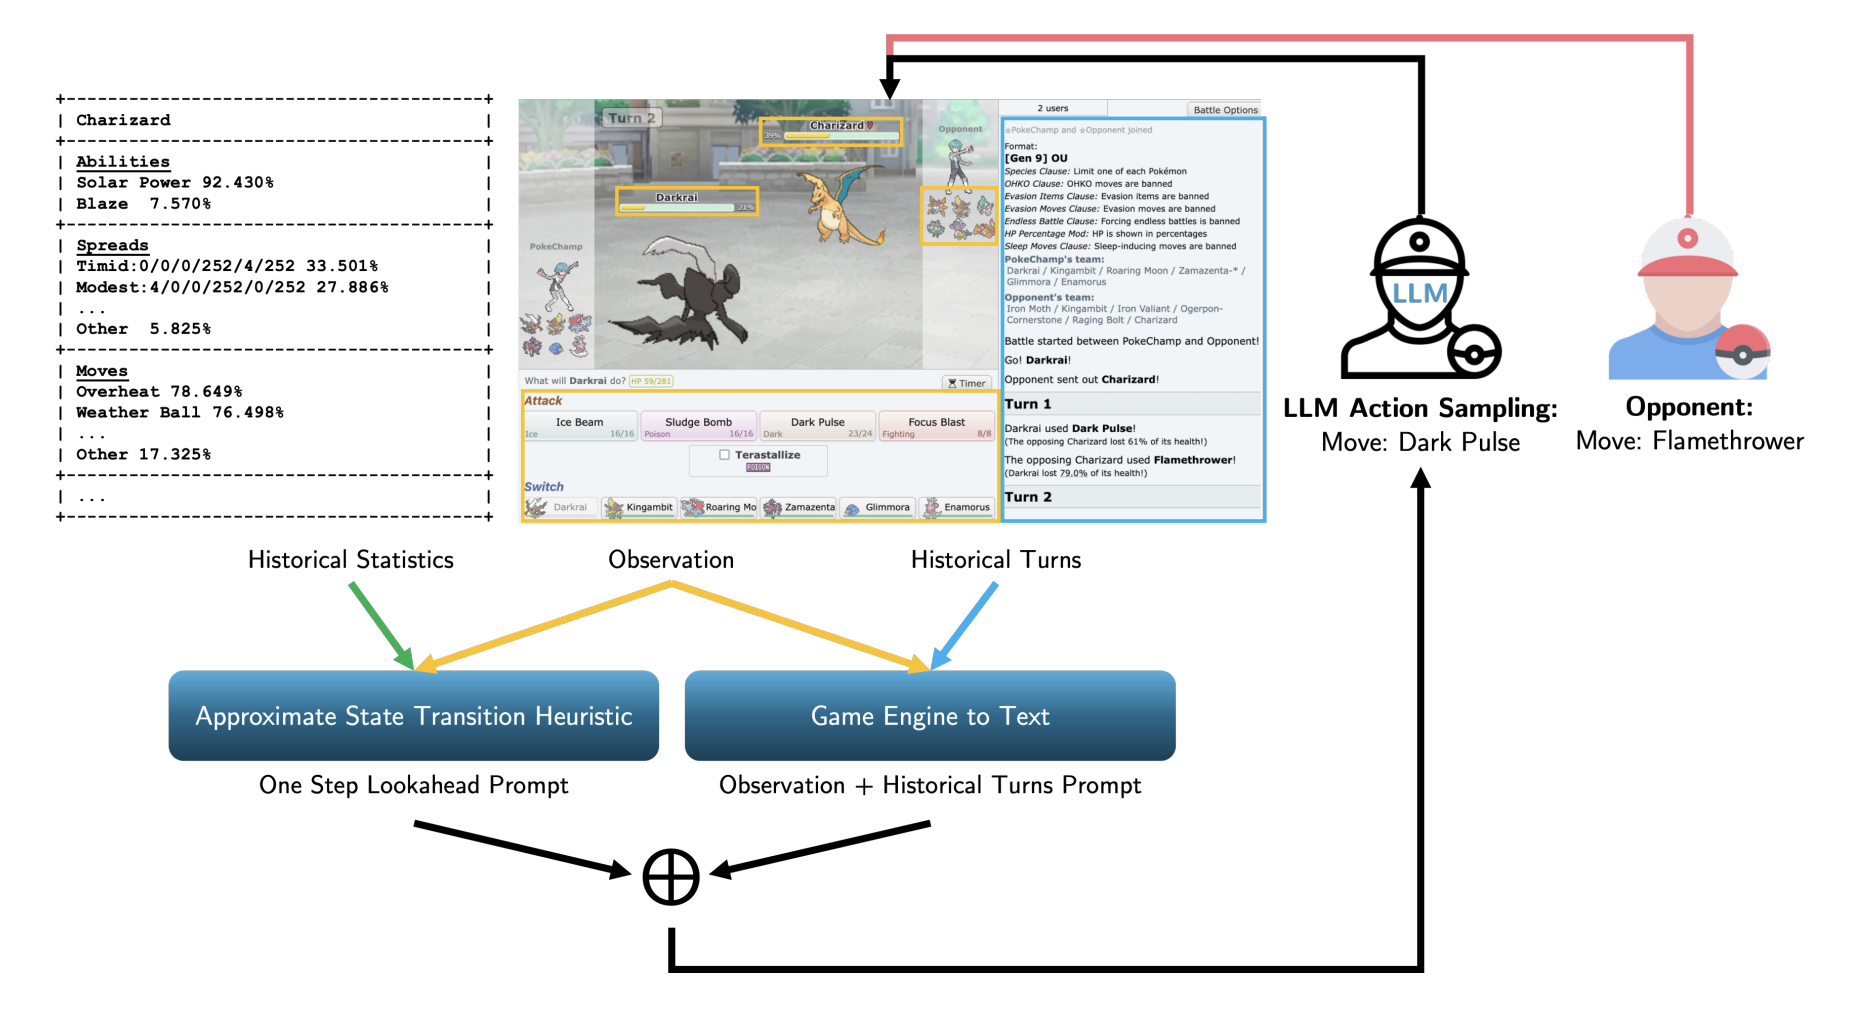
한편, 학습 없이 그저 LLM의 능력만을 활용한 연구에서는 배틀을 잘할 수 있도록 하네스 구조를 만들었습니다. 주어진 게임 상태를 텍스트로 바꾸고, 사용량 통계를 기반으로 상대의 포켓몬 정보를 추정하여 플레이합니다. |
|
|
오직 LLM으로 주어진 정보만을 활용하여 배틀하는 PokéChamp
출처: <PokéChamp: an Expert-level Minimax Language Agent> (Karten, Nguyen & Jin, 2025)
PokéAgent의 언어 모델 기본 에이전트는 프린스턴 대학교 연구진이 ICML 2025에서 발표한 PokéChamp를 확장해 만들었습니다. 이 모델의 근간에는 Minimax Search가 있습니다. 이는 ‘최대 피해를 최소화’하기 위한 전략인데요. 이번 결정이 끼칠 수 있는 피해 정도를 추산해, 최악의 경우에도 최소의 이득이 보장되는 수를 선택하는 전략입니다. 물론, 현실에서는 트리 구조의 끝까지 다다르기에 너무 많은 경우의 수가 있기 때문에 깊이를 제한하고, 특정 판단은 배제하는 가지치기 전략을 같이 사용합니다.
그 결과, GPT-4o를 사용한 PokéChamp는 기존 최고 언어 모델 기반 봇을 상대로 76% 승률을 기록했습니다. 이는 다른 LLM보다 잘 싸우는 수준에 불과합니다. 사람들이 대전하는 기준으로 환산하면 Elo 1300~1500 정도로, 인간 플레이어 상위 10~30% 수준으로 추정됩니다. 실제로는 실전 배틀 유저의 풀이 매우 좁기 때문에 상위권에 미치지 못하는 수준이라고 생각합니다.
게다가 실제 시간 제한이 추가되면 성능은 더욱 열화됩니다. 일반적으로 Reasoning Model은 한 번 답을 내리는 데 1분이 넘게 걸리는데요. 공식 대회에서 한 턴에 주어진 시간은 45초뿐입니다. 추가 학습 없이 해결하기 어려운 부분이기도 합니다.
시간이 무한정 주어지고 LLM이 더 똑똑해진다면 쉽게 풀릴까요? 그렇지도 않습니다. 현재 주어진 벤치마크는 주로 언어 이해나 문제 해결 능력에 초점을 맞추고 있습니다. 그래서 하나의 모델이 하나의 벤치마크에서만 뛰어난 것이 아니라, 다른 벤치마크에서도 모두 엇비슷하게 뛰어나기에 다른 능력을 예측하기도 쉽습니다.
그러나 포켓몬 배틀 성적은 예측이 어렵습니다. 물론, 포켓몬 배틀 지식이 필수 검증 요소는 아니기 때문에 각 모델마다 성능이 꽤 상이할 수밖에 없지만, 연구진은 기존 벤치마크와 거의 직교(Orthogonal)하는 수준이라고 표현합니다. 다시 말하면 불완전 정보와 압박 속에서 전략적으로 판단하는 능력은, 지금의 벤치마크가 놓치고 있는 능력이라는 뜻으로 볼 수 있습니다. |
|
|
이렇게 흥미로운 포켓몬 배틀 연구에 대해 알아봤습니다. 개인적으로 포켓몬 배틀은 2년 전부터 계속 관심을 가지고 실험해보던 분야인데요. 노력치, 성격 등을 분석하다 보면 ‘포켓몬은 통계’에 가깝다는 생각이 들어, AI가 도입되면 쉽게 제패할 줄 알았는데 생각 이상으로 쉽지 않았습니다. 그러나 한편으로 이런 어려움 때문에 ICML이나 NeurIPS와 같은 저명한 학술대회에 게재될 만큼 꽤 흥미로운 주제가 된 것 같아 즐겁습니다.
‘포켓몬’이라는 캐릭터성 때문에 가려져 있기는 하지만, 이런 복잡한 요소는 사람을 대하고 전략을 구축하는 에이전트에게 점점 더 필요한 능력이기도 합니다. 스포츠, 마케팅 등의 다양한 비즈니스 전략을 시뮬레이션하는 데 활용될 잠재적 가치도 높고요. 일례로 11명이 함께 뛰는 축구 경기도 아무리 뛰어난 선수들이 모이더라도 모든 경기를 제패하기 쉽지 않고, 승리를 위해서는 매번 주어진 환경에 맞춰 분석하고 전략을 수정해야 합니다. 이때 매 경기 다양한 환경에서 시뮬레이션한다면 승리 확률을 높일 수 있을 것입니다. 아직까지는 그 어떤 AI가 와도 힘든 일이겠지만요. |
|
|
딥 다이브 뉴스레터 잘 보고 계신가요? 여러분의 의견과 피드백을 받습니다 :) |
|
|
deep daiv.
manager@deepdaiv.com
|
|
|
|
|